给定训练预算,怎样选择每一步的学习率,才能让最后的损失最小?答案取决于目标函数、梯度噪声和优化器的更新方式。
统一把更新写成 $\theta_{t+1}=\theta_t-\eta_tu_t$。$u_t$ 包含预条件、动量或矩阵正交化,$\eta_t$ 是外部标量学习率。要优化的是固定预算后的 $\mathbb E[f(\theta_T)-f_*]$,其中 $f_*=f(\theta_*)$。
一般凸问题可以先优化终点误差上界;在可解的二次模型中,则能直接最小化真实终点损失。SGD 的 Linear Decay 来自前一种分析[1][2] ,并不是所有优化器、所有目标下的统一答案。
上界最小化与训练损失最小化是不同的目标。 本文的常数界图只说明所构造上界的线性最小解,没有证明带动量 Muon 的真实最优 ELR 是 Linear Decay。尤其不能把四张相同形状的示意图当作四种优化器具有相同最优调度的证据。
五篇文献中的 LR 与 ELR Schedule
先看近期工作实际提出或使用了什么。下表中的“理论解”指相应论文所定义的问题;训练配方的实验收益另列,不能仅凭曲线形状判断优劣。
| 文献 | 提出或使用的 Schedule | 控制量与证据 |
|---|---|---|
| Training nGPT[15] | 对数衰减(logarithmic decay) | GatedAdam 的标量 LR;归一化模型完整配方的实验 |
| From LR to ELR[16] | 负平方根、分段线性 | MuonH 的 ELR;nanoGPT 与 MoE scaling ladder 实验 |
| PuRo-2B[17] | 反平方根接线性;CMA 分支末段恒定 | MuonH 与辅助 AdamW 共用 base schedule,组间倍率不同 |
| Your LR Schedule May Not Be Principled[18] | AIR:仿射反平方根衰减 | 标量对齐模型的反平方根理论解;AIR 的 MoE 实验 |
| Hyperball May Not Be a Free Lunch[19] | Linear、指数/幂衰减与 SuperExp | MuonH 的 schedule 比较;关注早期与后期表现的取舍 |
这些文章的 ELR 定义并不完全相同。混元和 PuRo 使用投影前的相对更新幅度 $\varepsilon=\eta\|u\|/\|W\|$;AIR 使用 $e=\eta/\|W\|$,两者相差更新范数。最后一篇定义角度 ELR 为 $\Delta\phi/\|U\|_F$,其中 $\Delta\phi$ 是实际转角;它还计入参数与更新的夹角。只有补齐这些条件,才可以比较它们所说的 ELR[16][17][18][19] 。
下面用 $r\in[0,1]$ 表示相应衰减区间的进度。标为 $s(r)$ 的形状函数起终点为 $1,0$;实际 LR 可以通过 $\eta=\eta_{\min}+(\eta_{\rm peak}-\eta_{\min})s(r)$ 保留非零终点。各文的 warmup 与分段时间仍以原始配置为准。
Training nGPT:对数衰减
论文 §2.2 提出以下形状,实际配方取 $\rho=0.05$[15] :
$$ s_{\log}(r)=1-\frac{\log(1+r/\rho)}{\log(1+1/\rho)},\qquad \rho=0.05. $$nGPT 使用 GatedAdam,全局峰值为 $0.24/\sqrt{d_{\rm model}}$,末端降到零;部分参数另有倍率和前 10% 的 warmup,角步长上限也在该区间内升高。图 3 的统一 10% warmup 是曲线比较设置,不能当作所有参数的共同配置。AdamW 基线采用 WSD,经过 1B tokens warmup,最终降至峰值的 1%。两组还改变了参数化与优化器,因此整体收益不能单独归因于 logarithmic decay。
混元 ELR:负平方根与分段线性
混元从普通 Muon 的 AUS 轨迹出发,观察到短 warmup、高峰值、前期快速下降及后期平缓下降,据此为 MuonH 设计[16]
$$ s_{\rm msqrt}(r)=1-\sqrt r,\qquad r=\frac{t-T_w}{T-T_w}. $$Track 3 配方采用 100 步 warmup、峰值 $0.03$,在 3175 步达到验证损失 3.28;原 linear 配方需要 3250 步。峰值与 warmup 同时经过调整,这个结果比较的是配方。MoE scaling ladder 也在测量预算内显示收益,但原文提醒其优势未必延续到更大的预算。
另一方案是分段线性:warmup 后从 $(0,1)$ 快速降到中间点 $(r_c,h)$,再线性降到 $(1,0)$。它将早期下降与尾段分开调节;nanoGPT 实验中优于该文的 linear 和负平方根配置,中间点的跨规模迁移仍待验证。
PuRo:反平方根接线性,保留非零终点
PuRo v2 附录 C 给出了生产配方。Phase 1 的 base LR 先用 1000 步线性 warmup 到 $5\times10^{-3}$,随后采用[17]
$$ \eta_{\rm base}(k)=5\times10^{-4}+4.5\times10^{-3}\sqrt{1000/k},\qquad k>1000. $$Phase 2 从共同 checkpoint 的 $\eta_0\approx1.04\times10^{-3}$ 开始,按该分支已消耗的样本比例 $r$ 线性衰减:
$$ \eta_{\rm base}(r)=\eta_0+(10^{-5}-\eta_0)r. $$生产配置的 MuonH 矩阵组使用 $10\eta_{\rm base}$,即其投影前 ELR;其余组的 AdamW 使用 base LR。最终 CMA 分支在 global step 218000 改为恒定 base LR $4.08\times10^{-5}$,续训最后约 29B tokens 并平均 checkpoint。其 WSD 消融支持较长衰减区间,但没有证明反平方根指数或生产拼接点最优。
AIR:对齐模型中的反平方根解
AIR 先分析固定目标方向、切向更新以及恒定对齐统计下的标量模型。若 $m_k$ 表示对齐程度、$a,b>0$ 为固定系数,其递推与最优序列为[18]
$$ m_{k+1}=\frac{m_k+a\eta_k}{\sqrt{1+2b\eta_k^2}},\qquad \eta_k^*=\frac{\eta_0}{\sqrt{1+2b\eta_0^2k}},\qquad \eta_0=\frac{a}{2bm_0}. $$这个结果最优化的是该模型的最终对齐程度1。为了满足有限预算内指定的峰值与终点,实际 AIR 对反平方根函数再做仿射调整:
$$ q(k)=(1+k/\alpha)^{-1/2},\qquad \eta_{\rm AIR}(k)=\eta_{\min}+(\eta_{\rm peak}-\eta_{\min})\frac{q(k)-q(K)}{1-q(K)},\qquad \alpha=K/8. $$实验共 32047 步,前 3040 步 warmup,$\eta_{\min}=10^{-5}$。在 WN Muon 的 128B-token MoE 实验中,匹配累计 LR 后,AIR 的终点 loss 比 cosine 低约 $0.01$。理论最优性属于原始对齐模型,尚未覆盖仿射校准后的首尾约束,也不是实际 Muon 终点训练损失的全局最优性证明。
Hyperball May Not Be a Free Lunch:更早下降的代价
该文 §4.3 列出 linear、归一化指数和幂衰减,并实验比较多种 MuonH 配方;后两种形状写为[19]
$$ s_{\exp}(r)=\frac{e^{-\lambda r}-e^{-\lambda}}{1-e^{-\lambda}},\quad \lambda>0;\qquad s_{\rm pow}(r)=1-r^p,\quad p\in\{0.5,0.4\}. $$$p=0.5$ 就是负平方根。作者的 $p=0.4$ 复现配置用 100 步 warmup、100 步 hold、峰值 $0.03$,再衰减到 $10^{-5}$;这与论文公式的零终点需要区分[20] 。另有非零起点 warmup—超指数下降—线性归零的三阶段 SuperExp 实现,并非上式的归一化指数函数[21] 。实验显示,更激进的下降可以改善早期表现,却可能损害后期表现。这不是一条跨训练预算通用的最优曲线。
负平方根与反平方根是两种函数:混元的 $1-\sqrt r$ 属于前者;PuRo 的 $(1+cr)^{-1/2}$ 型片段和 AIR 的基础函数属于后者。PuRo 通过拼接阶段控制终点,AIR 通过仿射变换控制终点,不能把它们当成同一条 schedule。
直接把 ELR 作为优化变量
本文采用相对更新幅度的定义 $\varepsilon_t=\mathrm{ELR}_t=\eta_t\|u_t\|/\|\theta_t\|$[13] 。向量用二范数,矩阵用 Frobenius 范数;同一个参数块中,两者的 RMS 比值与范数比值相同。这个定义不包含解耦权重衰减,也不要求损失具有尺度不变性;只有更新近似垂直于参数且步长足够小时,它才近似角向更新幅度。
给定 LR 后计算 ELR,与直接优化 ELR,是两个不同的问题。 要直接控制 $\varepsilon_t$,定义范数比 $\gamma_t$ 和归一化方向 $d_t$:
$$ \gamma_t=\frac{\|u_t\|}{\|\theta_t\|},\qquad d_t=\frac{u_t}{\gamma_t},\qquad \theta_{t+1}=\theta_t-\varepsilon_td_t,\qquad \eta_t=\frac{\varepsilon_t}{\gamma_t}. $$以下考虑参数与更新范数均非零的单个参数块。除另有说明外,凸终点上界均假设实际更新不使用权重衰减。外部 LR 现在会根据当前参数、梯度及优化器状态反馈调整;它通常不是一条预先给定的时间曲线。若使用尺度下限或给外部 LR 设上限,就需要将这些约束另外放进优化问题。
从相对更新推导终点上界
固定 warmup 前缀后,保留实际参数与优化器状态,只将证明中的后续区间重新编号为 $t=1,\ldots,N$。实际步数不重置:Adam 的偏差修正、Adafactor 的时间相关系数仍使用全局训练步数。定义非负权重 $w_t$、$S=\sum_tw_t>0$,构造
$$ \varepsilon_t=\frac{w_t\sum_{s>t}w_s}{S},\qquad z_{t+1}=z_t-w_td_t,\qquad z_1=\theta_1. $$它满足终点转换所需的关系 $\theta_{t+1}-\theta_t=(\sum_{s>t}w_s/S)(z_{t+1}-z_t)$。终点转换允许任意辅助更新方向,因此在凸目标、当前原始梯度 $g_t$ 条件无偏、权重确定的条件下,仍然有[1]
$$ \mathbb E[f(\theta_N)-f_*]\leq\frac1S\mathbb E\sum_tw_t\langle g_t,z_t-\theta_*\rangle. $$接下来的归一化度量是本文在该转换上的推导。为每种优化器选择半正定矩阵 $K_t$,令 $E_t=z_t-\theta_*$、$\delta_t=g_t-K_td_t$。距离展开给出
$$ 2w_t\langle g_t,E_t\rangle=\|E_t\|_{K_t}^2-\|E_{t+1}\|_{K_t}^2+w_t^2\langle d_t,K_td_t\rangle+2w_t\langle\delta_t,E_t\rangle. $$假设 $\|E_t\|\leq R$。令 $\Lambda_N(K)=\lambda_{\max}(K_1)+\sum_{t=2}^N[\lambda_{\max}(K_t-K_{t-1})]_+$,并取对所有候选 ELR 反馈轨迹都成立的确定性界:
$$ A\geq R^2\mathbb E\Lambda_N(K),\qquad a_t\geq\mathbb E\langle d_t,K_td_t\rangle,\qquad b_t\geq R\,\mathbb E\|\delta_t\|,\qquad A,a_t>0. $$求和并控制末项,就得到直接关于 ELR 权重的终点上界:
$$ \boxed{\mathbb E[f(\theta_N)-f_*]\leq\mathcal B_{\rm ELR}(w)=\frac{A+\sum_ta_tw_t^2+2\sum_tb_tw_t}{2\sum_tw_t}.} $$令 $[x]_+=\max(x,0)$,由单调标量方程 $\sum_t(\lambda-b_t)_+^2/a_t=A$ 确定唯一的 $\lambda>\min_tb_t$,该固定上界的最小解为
$$ \boxed{w_t^*=\frac{(\lambda-b_t)_+}{a_t},\qquad \varepsilon_t^*=w_t^*\frac{\sum_{s>t}w_s^*}{\sum_sw_s^*},\qquad \mathcal B_{\rm ELR,min}=\lambda.} $$配方可直接验证全局最优性:
$$ 2S(\mathcal B_{\rm ELR}-\lambda)=\sum_ta_t(w_t-w_t^*)^2+2\sum_t(b_t-\lambda)_+w_t\geq0. $$这里的全局最优针对这个固定上界的权重优化;求出的权重还须属于共同界成立的候选集合,否则要在该集合内重新优化。零权重步骤的处理见脚注2。如果 $A,a_t,b_t$ 来自某一次训练记录,而没有控制更换调度后的变化,上述式子只能作为依赖旧统计的近似。
常数上界为什么给出线性示意
取 $a_t=a$、$b_t=b$ 时,$\lambda=b+\sqrt{Aa/N}$,所以
$$ \boxed{\varepsilon_t^*=\sqrt{\frac A{aN}}\left(1-\frac tN\right),\qquad \mathcal B_{\rm ELR,min}=b+\sqrt{\frac{Aa}{N}}.} $$图中先把能量与残差的时间变化统一放宽成常数,再求解这个代理上界。等权重导致线性尾段;这一形状来自常数化假设,而非 Muon 独有的动力学。四种优化器只是在各自的归一化度量下代入同一代数问题,本文并未证明相应上界紧,也未为实际 Muon 训练验证覆盖全部候选轨迹的共同界。
在上述公式中,$\varepsilon_t^*$ 的星号只表示所列上界的最小解。一般而言,$J(\varepsilon)\leq\mathcal B(\varepsilon)$ 并不保证两者的最小点相同。图中的 5% warmup、峰值归一化同样是预设,不在最优性结论之内。
一、SGD
先假设 $f$ 凸,$g_t$ 是当前点的条件无偏随机次梯度,外部权重为确定性序列。初始参数为 $\theta_1$,输出为 $\theta_T$,最后的 $\eta_T=0$ 只是边界约定3。
把终点误差写成加权和
引入正权重 $w_1,\ldots,w_T$,定义
$$ S=\sum_{t=1}^{T}w_t, \qquad \eta_t=\frac{w_t\sum_{s=t+1}^{T}w_s}{S}. $$再引入一个只用于证明的辅助序列
$$ z_1=\theta_1, \qquad z_{t+1}=z_t-w_tg_t. $$两条轨迹满足
$$ \theta_{t+1}-\theta_t =\frac{\sum_{s=t+1}^{T}w_s}{S}(z_{t+1}-z_t). $$Defazio 等人的终点转换定理,把这个关系与凸性结合,得到
$$ \mathbb E[f(\theta_T)-f_*] \leq\frac1S\mathbb E\sum_{t=1}^{T} w_t\langle g_t,z_t-\theta_*\rangle. $$右端现在是一个可以用平方距离递推控制的量。设 $D=\|\theta_1-\theta_*\|$,展开
$$ \|z_{t+1}-\theta_*\|^2 =\|z_t-\theta_*\|^2 -2w_t\langle g_t,z_t-\theta_*\rangle +w_t^2\|g_t\|^2. $$求和后中间项相消,末端平方距离非负,于是
$$ \boxed{ \mathbb E[f(\theta_T)-f_*] \leq \frac{D^2+\sum_{t=1}^{T}w_t^2\mathbb E\|g_t\|^2}{2S}. } $$梯度仍然在实际参数 $\theta_t$ 处计算。辅助序列不需要再做一次前向和反向传播。
梯度能量用同一个常数控制
若所有时刻都有 $\mathbb E\|g_t\|^2\leq G^2$,就可以优化
$$ \mathcal B(w)=\frac{D^2+G^2\sum_t w_t^2}{2\sum_t w_t}. $$先固定总和 $S$。由 Cauchy–Schwarz,
$$ \sum_{t=1}^{T}w_t^2\geq\frac{S^2}{T}, $$等号在 $w_t=S/T$ 时成立。因此最好的权重形状是常数,剩下的幅值问题为
$$ \min_{S>0}\left(\frac{D^2}{2S}+\frac{G^2S}{2T}\right). $$对 $S$ 求导,得到
$$ S^*=\frac{D\sqrt T}{G}, \qquad w_t^*=\frac{D}{G\sqrt T}. $$代回 $\eta_t$ 的构造式:
$$ \boxed{ \eta_t^*=\frac{D}{G\sqrt T}\left(1-\frac tT\right),\qquad \mathbb E[f(\theta_T)-f_*]\leq\frac{DG}{\sqrt T}. } $$线性来自“剩余权重的占比”:每一步的权重相等,剩余权重就与剩余步数成正比。这个速率达到一般凸随机优化的最优最坏情况阶[1] 。实际训练通常不知道 $D$ 和 $G$,因此会保留线性形状,另外搜索峰值学习率。
SGD 的 ELR 上界
SGD 的方向为 $u_t=g_t$,所以 $\gamma_t=\|g_t\|/\|\theta_t\|$、$d_t=g_t/\gamma_t$。取 $K_t=\gamma_t I$,便有 $K_td_t=g_t$,残差为零,而归一化能量变为
$$ \langle d_t,K_td_t\rangle=\frac{\|g_t\|^2}{\gamma_t}=\|\theta_t\|\,\|g_t\|. $$因此要控制的是 $a_t\geq\mathbb E[\|\theta_t\|\,\|g_t\|]$,而不是外部 LR 分析中的 $\mathbb E\|g_t\|^2$。取 $b_t=0$、$Q_t=\sum_{s\leq t}a_s^{-1}$,直接 ELR 上界的最优解为
$$ \boxed{\varepsilon_t^{\rm SGD,*}=\sqrt{\frac A{Q_N}}\frac1{a_t}\left(1-\frac{Q_t}{Q_N}\right),\qquad \eta_t^*=\varepsilon_t^{\rm SGD,*}\frac{\|\theta_t\|}{\|g_t\|}.} $$若 $a_t=a$,这个上界的线性最小解是 $\sqrt{A/(aN)}(1-t/N)$;对应的外部 LR 还乘着不断变化的范数比。前一节的线性 LR 与这里的线性 ELR 分别优化不同的上界,不能把两组结论同时无条件套在同一条训练轨迹上。

Warmup 后线性降到 0
固定总预算 $T$,在 $T_w$ 处结束 warmup,峰值学习率为 $\eta_{\rm pk}$,最小学习率为 $0$。用 $0\leq t\leq T$ 表示训练进度,这条调度曲线可以写成一行:
$$ \boxed{\eta(t)=\eta_{\rm pk}\min\!\left\{\frac{t}{T_w},\frac{T-t}{T-T_w}\right\},\qquad 0\lt T_w\lt T.} $$它在 $t=T_w$ 达到峰值,随后直接线性降到 $\eta(T)=0$,中间没有恒定学习率阶段。$t=T$ 是预算边界;最后一次实际更新是否使用零学习率,要按更新索引约定区分3。

前面的常数梯度界推出了线性衰减形状,没有同时求出 warmup 长度。Defazio 等人的实验为非自适应调度加入了固定 warmup;使用随时间变化的梯度统计所作的 refinement,也能产生 warmup,但曲线通常不再是严格的两段直线[1] 。
若先固定 warmup 前缀,可以把 warmup 后的参数作为新的初始点,在剩余区间重新应用终点上界。此时仍须满足凸性、原始梯度条件无偏等假设,并对候选后续调度使用共同的距离与能量界。这个分析支持衰减段的线性形状,不等于联合证明了整条 warmup 加衰减曲线、峰值和 warmup 长度都最优。
梯度随时间变化时
如果有一组预先给定的正数 $a_t$,满足 $\mathbb E\|g_t\|^2\leq a_t$,同样可以求解。令
$$ Q_t=\sum_{s=1}^{t}a_s^{-1}. $$固定 $S$ 时,加权 Cauchy–Schwarz 给出
$$ S^2\leq\left(\sum_t a_tw_t^2\right)Q_T. $$所以最优权重与 $a_t^{-1}$ 成正比。再优化 $S$,得到
$$ \boxed{ w_t^*=\frac{D}{a_t\sqrt{Q_T}},\qquad \eta_t^*=\frac{D}{a_t\sqrt{Q_T}} \left(1-\frac{Q_t}{Q_T}\right). } $$常数 $a_t$ 会恢复 Linear Decay。若早期梯度能量大,前面的 $a_t^{-1}$ 会压低步长;能量随后下降时,这个因子可能产生 warmup,但并非任意下降曲线都会产生 warmup。
这里的 $a_t$ 必须作为固定上界参与优化。若改用一次训练中观测到的梯度曲线,换 LR Schedule 后梯度也会变,公式就变成基于旧轨迹的 refinement;原论文采用的正是先记录、平滑,再用于后续训练的方式[1][2] 。它还需要未来的 $Q_T$,不能直接当作只看当前梯度的在线学习率算法。
二次模型的精确最优解
如果目标函数和噪声已知,可以绕过统一上界,直接求终点损失的最小值。考虑带加性噪声的一维二次模型:
$$ f(x)=\frac h2x^2,\qquad x_{t+1}=(1-h\eta_t)x_t-\eta_t\epsilon_t. $$设 $h>0$、$r_0=\mathbb E[x_0^2]>0$,噪声条件均值为零、条件方差为固定的 $\sigma^2>0$,学习率为非负确定性序列。这里从 $x_0$ 开始,执行 $N$ 次更新,最小化 $\mathbb E f(x_N)$。记 $r_t=\mathbb E[x_t^2]$,有精确递推
$$ r_{t+1}=(1-h\eta_t)^2r_t+\sigma^2\eta_t^2. $$对步长配方:
$$ r_{t+1} =\frac{\sigma^2r_t}{h^2r_t+\sigma^2} +(h^2r_t+\sigma^2) \left(\eta_t-\frac{hr_t}{h^2r_t+\sigma^2}\right)^2. $$因此一步最优为 $\eta_t^*=hr_t/(h^2r_t+\sigma^2)$。而最小可达的下一步误差
$$ \phi(r)=\frac{\sigma^2r}{h^2r+\sigma^2} $$关于 $r$ 单调增加。任何 LR Schedule 都有 $r_{t+1}\geq\phi(r_t)$,所以逐步达到等号,会同时最小化每个时刻的误差。这个标量模型中,一步最优恰好也是任意终点的全局最优4。
最优递推满足
$$ \frac1{r_{t+1}^*}=\frac1{r_t^*}+\frac{h^2}{\sigma^2}, $$从而
$$ \boxed{ \eta_t^*=\frac1{h\left(t+1+\dfrac{\sigma^2}{h^2r_0}\right)},\qquad \mathbb E f(x_N)_{\min} =\frac{h\sigma^2r_0}{2(\sigma^2+Nh^2r_0)}. } $$最优步长按反比衰减,不依赖预先指定的训练终点。
与 Linear 和 Cosine 比较
取 $h=\sigma^2=r_0=1$,总预算 $N=100$ 次更新,其中前 $W=5$ 次使用共同的线性 warmup:$\eta_t=a\,t/W$,$t=0,\ldots,W-1$。选择共同峰值 $a$,使其等于 warmup 后的一步最优率 $r_W/(1+r_W)$,这样后续曲线连续衔接;这只是峰值的选取规则,并未联合优化 warmup。
记 $j=t-W$,剩余 $95$ 次更新的四条曲线为
$$ \eta_t^*=\frac{r_W}{1+(j+1)r_W},\quad \eta_t^{\rm linear}=a\left(1-\frac j{95}\right),\quad \eta_t^{\rm cosine}=\frac a2\left[1+\cos\frac{\pi j}{95}\right],\quad \eta_t^{\rm constant}=a. $$数值上 $a\approx0.2721813991$、$r_W\approx0.3739687317$。四组从同一个 warmup 状态出发,共用峰值;下图直接递推期望误差,包含 warmup 的损失变化。深灰曲线的最优性只针对固定前缀后的尾段。

| LR Schedule | 共同峰值 | 第 100 步期望损失 |
|---|---|---|
| 固定 warmup 后的最优解 | $0.2721814$ | $0.0051191$ |
| Linear | $0.2721814$ | $0.0121102$ |
| Cosine | $0.2721814$ | $0.0120046$ |
| Constant | $0.2721814$ | $0.0787645$ |
在这个共同峰值的比较中,Cosine 的终点损失略低于 Linear,两者都高于最优尾段;这不代表各自重新调节峰值后的排名。前面推导的 Linear Decay 最小化一般凸问题的统一上界;这里利用二次结构求解固定 warmup 后的真实终点损失,得到不同的最优形状。
二、Adafactor
更新规则:因子化二阶矩与相对步长
Adafactor 用行、列统计量近似二阶矩,再对预条件更新做裁剪。以下采用原论文中不含一阶动量的矩阵版本[12] 。设 $W_t,G_t\in\mathbb R^{m\times n}$,$G_t$ 在 $W_t$ 处计算,$t\geq1$、$R_0=C_0=0$,稳定项 $\epsilon_1,\epsilon_2$ 与裁剪阈值 $d$ 均为正;所有平方、开方和除法均逐元素进行。
先给平方梯度加一个正的稳定项:
$$ B_t=G_t^{\odot2}+\epsilon_1\mathbf1_m\mathbf1_n^\top. $$行统计 $R_t\in\mathbb R^{m\times1}$ 与列统计 $C_t\in\mathbb R^{1\times n}$ 分别更新为
$$ R_t=\beta_{2,t}R_{t-1}+(1-\beta_{2,t})B_t\mathbf1_n, $$$$ C_t=\beta_{2,t}C_{t-1}+(1-\beta_{2,t})\mathbf1_m^\top B_t. $$据此重建二阶矩近似,并形成预条件方向:
$$ \widehat V_t=\frac{R_tC_t}{\mathbf1_m^\top R_t},\qquad U_t=G_t\oslash\sqrt{\widehat V_t}. $$因子化的是二阶矩估计,不是梯度本身。二阶矩状态只需存 $m+n$ 个数。接着定义 $\operatorname{RMS}(U)=\|U\|_F/\sqrt{mn}$,对更新做 RMS 裁剪:
$$ \kappa_t=\max\!\left(1,\frac{\operatorname{RMS}(U_t)}{d}\right),\qquad D_t=U_t/\kappa_t. $$最后乘上参数尺度 $s_t$ 和相对步长 $\rho_t$:
$$ s_t=\max(\epsilon_2,\operatorname{RMS}(W_t)),\qquad W_{t+1}=W_t-\rho_ts_tD_t. $$这里应区分两条曲线:$\rho_t$ 是相对步长,$\alpha_t=\rho_ts_t$ 是乘在裁剪方向 $D_t$ 上的绝对步长。即使 $\rho_t$ 线性衰减,只要参数 RMS 在变,$\alpha_t$ 就不再是直线。
原论文提出的配置为 $\beta_{2,t}=1-t^{-0.8}$、$\rho_t=\min(10^{-2},t^{-1/2})$,也实验了带 warmup 的 $\rho_t=\min(10^{-6}t,t^{-1/2})$。这些是算法配置与实验选择,不能直接视为终点损失的最优解。
先求一步最优的相对步长
条件在更新前的历史 $\mathcal F_{t-1}$ 上,$s_t$ 已知,而 $D_t$ 仍取决于当前随机梯度。定义方向的对齐与平方长度:
$$ \mathcal A_t=\mathbb E[\langle\nabla f(W_t),D_t\rangle_F\mid\mathcal F_{t-1}],\qquad \mathcal V_t=\mathbb E[\|D_t\|_F^2\mid\mathcal F_{t-1}]. $$若 $f$ 的梯度是 $L_s$-Lipschitz,光滑性给出
$$ \mathbb E[f(W_t-\rho s_tD_t)\mid\mathcal F_{t-1}]\leq f(W_t)-\rho s_t\mathcal A_t+\frac{L_s\rho^2s_t^2\mathcal V_t}{2}. $$当 $\mathcal V_t>0$,对右端求非负极小值得到
$$ \boxed{\rho_t^{\rm one}=\frac{[\mathcal A_t]_+}{L_ss_t\mathcal V_t},\qquad \alpha_t^{\rm one}=\frac{[\mathcal A_t]_+}{L_s\mathcal V_t}.} $$裁剪保证 $\mathcal V_t\leq mn\,d^2$,但没有固定 $\mathcal A_t$。所以“更新长度有界”本身推不出 Linear 或 Inverse Square Root。这一步只最小化当前下降上界,还没有考虑学习率对后续参数、二阶矩和裁剪状态的影响。
从变度量递推求终点上界
把矩阵展平成向量,记 $g_t=\operatorname{vec}(G_t)$、$\theta_t=\operatorname{vec}(W_t)$。Adafactor 可以写成
$$ \theta_{t+1}=\theta_t-\rho_tH_t^{-1}g_t,\qquad H_t=\frac{\kappa_t}{s_t}\operatorname{diag}\!\left(\operatorname{vec}\sqrt{\widehat V_t}\right). $$滑动平均、更新裁剪和参数尺度都进入了 $H_t$,因此不能假设 $H_t$ 单调增加。沿用 SGD 的权重构造 $\rho_t=w_t\sum_{s>t}w_s/S$,引入 $z_{t+1}=z_t-w_tH_t^{-1}g_t$、$z_1=\theta_1$,写 $e_t=z_t-\theta_*$。加权平方距离满足
$$ 2w_t\langle g_t,e_t\rangle=\|e_t\|_{H_t}^2-\|e_{t+1}\|_{H_t}^2+w_t^2g_t^\top H_t^{-1}g_t. $$前两项求和,得到
$$ \|e_1\|_{H_1}^2-\|e_{T+1}\|_{H_T}^2+\sum_{t=2}^{T}e_t^\top(H_t-H_{t-1})e_t. $$若辅助轨迹满足 $\|e_t\|\leq R$,可以用预条件矩阵的累计正向变化控制它:
$$ \Lambda_T(H)=\lambda_{\max}(H_1)+\sum_{t=2}^{T}[\lambda_{\max}(H_t-H_{t-1})]_+. $$因为每个变化项不超过 $R^2[\lambda_{\max}(H_t-H_{t-1})]_+$,上面的距离和至多为 $R^2\Lambda_T(H)$。这个变度量处理也适用于其他非单调预条件器[3] 。
在凸目标、原始随机梯度条件无偏的假设下,代入终点转换:
$$ \mathbb E[f(\theta_T)-f_*]\leq\frac{R^2\mathbb E\Lambda_T(H)+\sum_t w_t^2\mathbb E[g_t^\top H_t^{-1}g_t]}{2S}. $$这里不要求预条件后的方向无偏。距离恒等式对每个样本成立,无偏性只用于原始梯度 $g_t$ 与凸性的关系。Adafactor 对应的能量为
$$ g_t^\top H_t^{-1}g_t=\frac{s_t}{\kappa_t}\sum_{i,j}\frac{G_{t,ij}^2}{\sqrt{\widehat V_{t,ij}}}. $$注意它不同于更新的欧氏平方长度 $g_t^\top H_t^{-2}g_t$。若对候选 LR Schedule 存在共同的确定性界
$$ R^2\mathbb E\Lambda_T(H)\leq A,\qquad \mathbb E[g_t^\top H_t^{-1}g_t]\leq a_t,\qquad A>0,\ a_t>0, $$要优化的上界就是 $\mathcal B(w)=(A+\sum_ta_tw_t^2)/(2\sum_tw_t)$。令 $Q_t=\sum_{s=1}^ta_s^{-1}$,沿用 SGD 的加权 Cauchy–Schwarz,得到
$$ \boxed{\rho_t^*=\sqrt{\frac A{Q_T}}\frac1{a_t}\left(1-\frac{Q_t}{Q_T}\right),\qquad \mathcal B_{\min}=\sqrt{\frac A{Q_T}}.} $$将 $a_t$ 用同一个常数 $a$ 控制时,便得到相对步长的 Linear Decay:
$$ \boxed{\rho_t^*=\sqrt{\frac A{aT}}\left(1-\frac tT\right),\qquad \alpha_t^*=s_t\rho_t^*.} $$这个结果优化的是固定界 $A,a_t$ 下的终点误差上界,求出的调度还须属于这些界成立的候选集合。实际的 $s_t,\kappa_t,\widehat V_t$ 会随调度改变;直接把某次训练的统计量代入,并不能得到原训练问题的全局最优解。要让上界趋于零,还需 $A/Q_T\to0$,仅有每一步的 $H_t$ 有界并不足够。
Adafactor 的 ELR 上界
Adafactor 的实际相对更新量为 $\varepsilon_t=\rho_ts_t\|D_t\|_F/\|W_t\|_F$。即使参数尺度下限没有触发,也只有 $\operatorname{RMS}(D_t)=1$ 时才有 $\varepsilon_t=\rho_t$;相对步长 $\rho_t$ 不能直接当作实测 ELR。
记裁剪前的方向仍为 $U_t=G_t\oslash\sqrt{\widehat V_t}$。在直接控制 ELR 时,整体参数尺度与 RMS 裁剪因子从归一化方向中抵消:
$$ d_t=\frac{\|W_t\|_F}{\|U_t\|_F}U_t,\qquad K_t=\frac{\|U_t\|_F}{\|W_t\|_F}\operatorname{diag}(\operatorname{vec}\sqrt{\widehat V_t}). $$矩阵按向量展平后,$K_td_t=g_t$,所以 $b_t=0$。对应的能量是
$$ \langle d_t,K_td_t\rangle=\frac{\|W_t\|_F}{\|U_t\|_F}\sum_{i,j}\frac{G_{t,ij}^2}{\sqrt{\widehat V_{t,ij}}}. $$对这个量采用共同界 $a_t$,并控制 $K_t$ 的累计变化 $A$,令 $Q_t=\sum_{s\leq t}a_s^{-1}$,便得到
$$ \boxed{\varepsilon_t^{\rm Ada,*}=\sqrt{\frac A{Q_N}}\frac1{a_t}\left(1-\frac{Q_t}{Q_N}\right),\qquad \rho_t^*=\varepsilon_t^{\rm Ada,*}\frac{\|W_t\|_F}{s_t\|D_t\|_F}.} $$在常数 $a_t=a$ 下,上界的最小解仍是线性尾段;因子化二阶矩进入 $a$ 和 $A$,并没有消失。实现这个 ELR 控制会通过 $\rho_t$ 补偿标量裁剪;如果另外限制 $\rho_t$ 或更新幅度,就必须在该可行集合内重新优化。

补充:AdaGrad 的单调预条件与外部线性衰减
预条件以后要换一个能量
考虑没有一阶动量的预条件更新
$$ \theta_{t+1}=\theta_t-\eta_t H_t^{-1}g_t, \qquad H_t\succ0. $$将辅助更新改为 $z_{t+1}=z_t-w_tH_t^{-1}g_t$,平方距离也改用 $H_t$ 定义的度量。若 $H_t\succeq H_{t-1}$,且辅助轨迹满足 $\|z_t-\theta_*\|\leq R$,相同方法给出
$$ \mathbb E[f(\theta_T)-f_*] \leq \frac{R^2\mathbb E\operatorname{tr}(H_T) +\sum_t w_t^2\mathbb E[g_t^\top H_t^{-1}g_t]}{2S}. $$这个推广由预条件距离的望远镜求和得到[3] 。它需要控制辅助轨迹;仅仅知道实际参数 $\theta_t$ 有界还不够。
注意这里出现的是
$$ g_t^\top H_t^{-1}g_t, $$而更新向量的欧氏平方长度是 $g_t^\top H_t^{-2}g_t$。少一个逆矩阵幂次,会改变整条调度曲线。
如果对所比较的 LR Schedule 有共同的界
$$ R^2\mathbb E\operatorname{tr}(H_T)\leq A, \qquad \mathbb E[g_t^\top H_t^{-1}g_t]\leq B, $$那么问题再次变成
$$ \min_{w_t>0}\frac{A+B\sum_t w_t^2}{2\sum_t w_t}, $$于是
$$ \boxed{\eta_t^*=\sqrt{\frac{A}{BT}}\left(1-\frac tT\right).} $$$A$、$B$ 固定是这个优化步骤的条件。求出的 LR Schedule 还须属于这些共同界成立的候选集合;否则需要在可行集合内重新优化。
为什么单调预条件矩阵会给出迹项
写 $e_t=z_t-\theta_*$,直接展开有
$$ 2w_t\langle g_t,e_t\rangle =\|e_t\|_{H_t}^2-\|e_{t+1}\|_{H_t}^2 +w_t^2g_t^\top H_t^{-1}g_t. $$前两项求和后成为
$$ \|e_1\|_{H_1}^2-\|e_{T+1}\|_{H_T}^2 +\sum_{t=2}^{T}e_t^\top(H_t-H_{t-1})e_t. $$对半正定矩阵 $M$,$e^\top Me\leq\|e\|^2\operatorname{tr}(M)$。用 $\|e_t\|\leq R$ 控制距离,再将迹相加,便得到 $R^2\operatorname{tr}(H_T)$。
AdaGrad 的外部调度与坐标步长
AdaGrad 的对角预条件矩阵为
$$ H_{t,ii}=\sqrt{\epsilon+\sum_{s=1}^{t}g_{s,i}^2}. $$累计平方和单调增加,满足这里需要的矩阵单调性。不过,预条件梯度能量并不因此恒定:若原始梯度的二阶矩近乎平稳,累计分母仍会增长。常数 $B$ 是用于分析的统一上界。取线性外部调度后,更新写成
$$ \boxed{ \theta_{t+1,i}=\theta_{t,i} -\underbrace{\eta_0\left(1-\frac tT\right)}_{\text{全局学习率}} \frac{g_{t,i}}{\sqrt{\epsilon+\sum_{s=1}^{t}g_{s,i}^2}}. } $$逐坐标的完整步长包含自适应分母,因此它本身不必是直线。
把 AdaGrad 的经典遗憾界与终点转换结合,还能得到等权结论,并保留逐坐标的梯度信息[4] 。
用 AdaGrad 的遗憾界重新求一次最优权重
给辅助 AdaGrad 输入 $h_t=w_tg_t$。为简化记号,先忽略数值稳定项,零分母且零分子时把该坐标更新定义为零。若存在统一常数 $D_\infty$,使 $\|z_t-\theta_*\|_\infty\leq D_\infty$,取基础步长 $\alpha=D_\infty/\sqrt2$,有
$$ \sum_t w_t\langle g_t,z_t-\theta_*\rangle \leq\sqrt2D_\infty\sum_i\sqrt{\sum_t w_t^2g_{t,i}^2}. $$若 $\mathbb E[g_{t,i}^2]\leq G_i^2$,由 Jensen 不等式及终点转换,
$$ \mathbb E[f(\theta_T)-f_*] \leq\sqrt2D_\infty\Bigl(\sum_iG_i\Bigr) \frac{\sqrt{\sum_t w_t^2}}{\sum_t w_t}. $$最后一个比值的最小值是 $T^{-1/2}$,等权重取到。此时 $w_t$ 在辅助 AdaGrad 的分子与累计平方根中抵消;终点转换额外乘上的剩余权重比例就是 $1-t/T$。这给出 AdaGrad 外部线性调度的另一条证明,并保留了它逐坐标适应梯度大小的结构。
三、Adam
二阶矩预条件与一阶动量
Adam 用滑动平均估计梯度的一阶、二阶矩[5] :
$$ m_t=\beta_1m_{t-1}+(1-\beta_1)g_t,\qquad v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^{\odot2}. $$从 $m_0=v_0=0$ 出发,偏差修正后的状态与更新为
$$ \widehat m_t=\frac{m_t}{1-\beta_1^t},\qquad \widehat v_t=\frac{v_t}{1-\beta_2^t},\qquad u_t=\widehat m_t\oslash(\sqrt{\widehat v_t}+\epsilon). $$令 $H_t=\operatorname{diag}(\sqrt{\widehat v_t}+\epsilon)$,则 $\theta_{t+1}=\theta_t-\eta_tH_t^{-1}\widehat m_t$。与 Adafactor 一样,二阶矩滑动平均不保证 $H_t$ 单调,所以仍需控制 $\Lambda_T(H)$。Adam 的收敛反例与 AMSGrad 对二阶矩历史最大值的使用,也说明不能省略对预条件器变化的控制[6] 。
一阶动量带来另一个差别:
$$ \mathbb E[m_t\mid\mathcal F_{t-1}]=\beta_1m_{t-1}+(1-\beta_1)\nabla f(\theta_t). $$它一般不等于当前梯度。偏差修正消除的是从零初始化的缩放偏差,没有消除旧梯度与当前梯度之间的差异。
将动量偏差保留在终点上界中
令辅助更新为 $z_{t+1}=z_t-w_tH_t^{-1}\widehat m_t$,仍取 $\eta_t=w_t\sum_{s>t}w_s/S$。展开距离得到的是 $\langle\widehat m_t,z_t-\theta_*\rangle$,而凸性需要原始梯度 $g_t$。把 $g_t=\widehat m_t+(g_t-\widehat m_t)$ 代入,得到
$$ \mathbb E[f(\theta_T)-f_*]\leq\frac{R^2\mathbb E\Lambda_T(H)+\sum_tw_t^2\mathbb E[\widehat m_t^\top H_t^{-1}\widehat m_t]}{2S}+\mathcal C_T, $$其中动量修正项为
$$ \mathcal C_T=\frac1S\sum_tw_t\,\mathbb E\langle g_t-\widehat m_t,z_t-\theta_*\rangle. $$仍假设目标凸、原始随机梯度条件无偏、$\|z_t-\theta_*\|\leq R$。选取对候选 LR Schedule 共同成立的固定界:
$$ A\geq R^2\mathbb E\Lambda_T(H),\qquad a_t\geq\mathbb E[\widehat m_t^\top H_t^{-1}\widehat m_t], $$$$ b_t\geq R\,\mathbb E\|g_t-\widehat m_t\|,\qquad A>0,\ a_t>0. $$由 Cauchy–Schwarz,$\mathcal C_T\leq\sum_tw_tb_t/S$。
需要优化的完整表达式变成
$$ \mathcal B_{\rm mom}(w) =\frac{A+\sum_ta_tw_t^2+2\sum_tb_tw_t}{2\sum_tw_t}. $$若标量方程
$$ \sum_t\frac{(\lambda-b_t)^2}{a_t}=A $$有满足 $\lambda>\max_t b_t$ 的解,则
$$ \boxed{ w_t^*=\frac{\lambda-b_t}{a_t},\qquad \eta_t^*=w_t^*\frac{\sum_{s>t}w_s^*}{\sum_sw_s^*},\qquad \mathcal B_{\rm mom,min}=\lambda. } $$验证只需配方。对任意正权重,
$$ 2S[\mathcal B_{\rm mom}(w)-\lambda] =\sum_ta_t(w_t-w_t^*)^2\geq0. $$若 $b_t=b$ 为常数,它只使最小上界增加 $b$,不改变最佳权重形状。若偏差界随时间变化,最优权重也会变化。正分支条件不满足时,最优解可能落到零权重边界,不能直接使用上面的正权重公式2。
当 $a_t=a$、$b_t=b$ 都取常数时,$\lambda=b+\sqrt{Aa/T}$,所以
$$ \boxed{\eta_t^*=\sqrt{\frac A{aT}}\left(1-\frac tT\right),\qquad \mathcal B_{\rm mom,min}=b+\sqrt{\frac{Aa}{T}}.} $$共同的常数能量界与偏差界给出了这个线性解,求出的权重还须属于这些界成立的候选集合。若 $b$ 不随训练预算减小,上界还会留下一个误差底;这并不是 Adam 自动收敛到最优点的证明。
Adam 的 ELR 上界
对 Adam 取 $u_t=H_t^{-1}\widehat m_t$、$\gamma_t=\|u_t\|/\|\theta_t\|$。直接 ELR 的归一化度量是 $K_t=\gamma_tH_t$,因而
$$ K_td_t=\widehat m_t,\qquad \langle d_t,K_td_t\rangle=\frac{\widehat m_t^\top H_t^{-1}\widehat m_t}{\gamma_t},\qquad \delta_t=g_t-\widehat m_t. $$这次的能量界应取 $a_t\geq\mathbb E[\widehat m_t^\top H_t^{-1}\widehat m_t/\gamma_t]$,动量偏差界仍为 $b_t\geq R\,\mathbb E\|g_t-\widehat m_t\|$。$A$ 要控制的是 $K_t$ 的变化,而非原来的 $H_t$。
由 $\sum_t(\lambda-b_t)_+^2/a_t=A$ 求出 $\lambda$ 后,该上界的 ELR 最小解及其对应外部 LR 为
$$ \boxed{w_t^*=\frac{(\lambda-b_t)_+}{a_t},\qquad \varepsilon_t^{\rm Adam,*}=\frac{w_t^*\sum_{s>t}w_s^*}{\sum_sw_s^*},\qquad \eta_t^*=\frac{\varepsilon_t^{\rm Adam,*}}{\gamma_t}.} $$再取共同常数界 $a_t=a,b_t=b$,就得到该上界的线性 ELR 解;时间变化的动量偏差会改变最优权重。这里没有用某个平稳噪声模型下的 update RMS 常数替代实际 $\gamma_t$,偏差修正也保留在 $\widehat m_t$ 中。

直接优化真实终点:把矩估计也纳入状态
对于实际非凸训练,可以把每一步学习率作为变量,沿完整训练过程求导[11] 。以 AdamW 为例,更新额外包含解耦权重衰减[7] :
$$ \theta_{t+1}=(1-\lambda_{\rm wd}\eta_t)\theta_t-\eta_tu_t. $$取 $X_t=(\theta_t,m_{t-1},v_{t-1})$,完整更新记为 $X_{t+1}=F_t(X_t,\eta_t,\xi_t)$。这里执行 $t=1,\ldots,N$ 共 $N$ 次更新,目标为 $J(\eta)=\mathbb E f(\theta_{N+1})$。对固定的随机样本序列反向传播:
$$ p_{N+1}=(\nabla f(\theta_{N+1}),0,0),\qquad p_t=(D_XF_t)^\top p_{t+1}. $$在可微、允许交换求导与期望、且基础随机采样分布不依赖调度的条件下,有
$$ \boxed{\frac{\partial J}{\partial\eta_t}=-\mathbb E\langle p_{t+1}^{\theta},u_t+\lambda_{\rm wd}\theta_t\rangle.} $$$p_{t+1}^{\theta}$ 包含此后所有梯度与矩估计的变化,不能替换成当前梯度。内部最优点要求这个导数为零;在 $\eta_t=0$ 的边界处,右导数应非负。这给出了数值求解完整 LR Schedule 的条件,但非凸问题的驻点通常不保证全局最优。
对 Adafactor,同样取 $X_t=(W_t,R_{t-1},C_{t-1})$,得到 $\partial J/\partial\rho_t=-\mathbb E\langle p_{t+1}^{W},s_tD_t\rangle_F$。反向递推必须包含参数尺度、二阶矩重建与裁剪;在裁剪和尺度下限的转折点,需要按实际实现处理分段导数。
AdamW 的权重衰减还会带来累计因子 $\prod_t(1-\lambda_{\rm wd}\eta_t)$。固定衰减系数而更换 LR Schedule,同时也改变了这部分训练动态,因此前面无权重衰减的凸上界不能直接原样套用。
四、Muon
Muon 先累积动量,再对更新矩阵作 Newton–Schulz 变换。用 EMA 记号写出 Nesterov 版本,区分动量缓存 $B_t$ 与送入矩阵变换的 $M_t$[8][14] :
$$ B_t=\beta B_{t-1}+(1-\beta)G_t,\qquad M_t=(1-\beta)G_t+\beta B_t,\qquad U_t=s_t\Phi(M_t). $$普通动量版本取 $M_t=B_t$。$\Phi$ 表示实际采用的矩阵变换,$s_t$ 包含矩阵倍率。外部 LR 出现在参数更新中:$W_{t+1}=(1-\eta_t\lambda_{\rm wd})W_t-\eta_tU_t$。
带动量 Muon 的 ELR 上界
直接 ELR 分析先取 $\lambda_{\rm wd}=0$,保留动量与有限次 Newton–Schulz。记 $P_t=\Phi(M_t)$、$L_t=(M_tM_t^\top)^{1/2}$。对 $U_t=s_tP_t$ 进行相对归一化后,矩阵倍率 $s_t>0$ 抵消,得到
$$ d_t=\frac{\|W_t\|_F}{\|P_t\|_F}P_t,\qquad K_t=\frac{\|P_t\|_F}{\|W_t\|_F}L_t,\qquad K_td_t=L_tP_t. $$于是归一化能量与残差分别为
$$ \mathcal E_t=\frac{\|W_t\|_F}{\|P_t\|_F}\operatorname{tr}(P_t^\top L_tP_t),\qquad \delta_t=G_t-L_tP_t. $$令 $a_t\geq\mathbb E\mathcal E_t$、$b_t\geq R\,\mathbb E\|\delta_t\|_F$,并用 $A$ 控制归一化度量 $K_t$ 的累计变化。完整残差同时包含动量滞后和有限次矩阵迭代误差:$\delta_t=(G_t-M_t)+(M_t-L_tP_t)$。求解 $\sum_t(\lambda-b_t)_+^2/a_t=A$ 后,得到
$$ \boxed{w_t^*=\frac{(\lambda-b_t)_+}{a_t},\qquad \varepsilon_t^{\rm Muon,*}=\frac{w_t^*\sum_{s>t}w_s^*}{\sum_sw_s^*},\qquad \eta_t^*=\varepsilon_t^{\rm Muon,*}\frac{\|W_t\|_F}{s_t\|P_t\|_F}.} $$如果用非零奇异值对应的紧致 SVD 构造精确部分极分解,不对零奇异值方向作正交补全,且 $\operatorname{rank}(M_t)=k_t>0$,则 $\|P_t\|_F=\sqrt{k_t}$、$L_tP_t=M_t$,能量简化为 $\mathcal E_t=\|W_t\|_F\|M_t\|_*/\sqrt{k_t}$;动量偏差 $G_t-M_t$ 仍须保留。实际使用有限次 Newton–Schulz 时,应使用前面的完整能量与残差,不能直接代入这个简式。
如果将 $a_t,b_t$ 统一放宽为常数 $a,b$,这个代理上界的最小解为 $\sqrt{A/(aN)}(1-t/N)$。这没有推出“Muon 的最优 ELR 是线性”:动量与有限次 Newton–Schulz 虽然保留在距离恒等式中,其时间信息在常数化后已经丢失;上界最小点也未必最小化真实终点损失。保留时间相关的 $a_t,b_t$ 只能给出依赖这些界的条件解,它们还必须共同适用于改变 ELR 后的轨迹。

一个带动量 Muon 的解析反例
考虑无噪声二次目标 $f(W)=\tfrac12\|W\|_F^2$,初值 $W_0=cI$,$c>0$,不加权重衰减。规定每个实际更新的 ELR 满足 $0\leq\varepsilon_t\leq\bar\varepsilon$,其中 $0<\bar\varepsilon<1$。普通或 Nesterov 动量取 $0\leq\beta<1$、初始缓存为零。
梯度、动量及送入正交化的矩阵始终是正标量乘 $I$。精确极分解和本文的五步 Newton–Schulz 都保持这个方向5,因此直接控制 ELR 时,归一化方向恰好是 $d_t=W_t$:
$$ W_{t+1}=(1-\varepsilon_t)W_t,\qquad f(W_T)=f(W_0)\prod_{t=0}^{T-1}(1-\varepsilon_t)^2. $$每个因子都随 $\varepsilon_t$ 严格减小,故这个问题的真实终点最优解为
$$ \varepsilon_t^*=\bar\varepsilon\qquad\text{(每个可自由选择的实际更新步骤)}. $$固定 warmup 后,最优尾段仍是常数。预算边界补画 $\varepsilon_T=0$ 不参与更新;即使规定最后一个实际步长为零,其余自由步骤仍取上限,而非逐步线性衰减。这个反例保留了动量,说明最优形状不能仅由“Muon”这个算法名称确定。
给定线性 LR 后,ELR 怎样变化
记权重 RMS 为 $r_t$、非衰减更新 RMS 为 $q_t$,相对更新幅度定义为
$$ \mathrm{ELR}_t=\frac{\eta_t q_t}{r_t}=\frac{\eta_t\|U_t\|_F}{\|W_t\|_F}. $$外部 LR 线性下降,并不意味着 ELR 也线性下降。苏剑林在《从参数对称性到有效学习率》中,先选取 Linear Decay 作为外部 LR,再用 Adam 的更新尺度和权重范数近似推算 ELR;最后提出相似渐近形状可以推广到 Muon[13] 。这一步讨论的是 LR 到 ELR 的映射。
令 $s=t/T\in[0,1]$ 表示完整训练进度,warmup 占比为 $w=0.05$。外部 LR 取 $\eta(s)=\eta_{\rm pk}\min\{s/w,(1-s)/(1-w)\}$。在整个区间上采用 $q(s)\approx q_0$、$r^2(s)\approx r_\infty^2(1-c_0e^{-\kappa s})$ 的范数增长模型,并按 warmup 结束时的值归一化:
$$ \boxed{\frac{\mathrm{ELR}(s)}{\mathrm{ELR}(w)}\approx\frac{\eta(s)}{\eta_{\rm pk}}\sqrt{\frac{1-c_0e^{-\kappa w}}{1-c_0e^{-\kappa s}}}},\qquad 0\lt c_0\lt1,\ \kappa\gt0. $$warmup 期间,外部 LR 线性升高,ELR 还受到增长的权重范数影响。进入衰减段后,分子随外部 LR 线性减小,分母随权重范数增大,因此 ELR 在衰减前期下降更快;范数接近平台后,它才近似按直线下降。这里的单指数范数模型是参考近似,$c_0,\kappa$ 需要由具体训练确定,不能从优化器名称直接读出。

Muon 的常数不能直接照搬 Adam。例如精确极分解下,若 $W_t\in\mathbb R^{m\times n}$、$\operatorname{rank}(M_t)=k$,则 $q_t^2=s_t^2k/(mn)$。动量会影响更新方向的时间相关性,而不只是给这个幅度乘一个 Adam 式的因子。带权重衰减时,范数严格满足
$$ r_{t+1}^2=(1-\lambda_{\rm wd}\eta_t)^2r_t^2+\eta_t^2q_t^2-\frac{2\eta_t(1-\lambda_{\rm wd}\eta_t)}{mn}\langle W_t,U_t\rangle_F. $$动量和有限次 Newton–Schulz 都会影响右端,交叉项不能直接删去。因此,图中的弯曲 ELR 是特定渐近假设下的参考形状,尚未求出实际带动量 Muon 的全局最优外部 LR。若目标是让 ELR 服从某条指定曲线 $e_t$,需要设置 $\eta_t=e_t r_t/q_t$,并考虑 $r_t,q_t$ 也会随新调度改变。
外部 LR 的终点上界
下面回到与 SGD 相同的凸终点上界问题。先用无动量、精确极分解说明矩阵能量的来源,再保留动量与有限次 Newton–Schulz 的影响。只有进一步采用共同常数界,才会再次得到线性形状;这与上面的 ELR 映射是不同的分析。
把正交化写成矩阵预条件
设参数与梯度为矩阵 $W_t,G_t$。对只保留非零奇异值的紧致 SVD,定义
$$ G_t=P_t\Sigma_tV_t^\top, \qquad \operatorname{polar}(G_t)=P_tV_t^\top. $$零梯度的更新定义为零。令
$$ H_t=(G_tG_t^\top)^{1/2}, $$则利用 Moore–Penrose 伪逆 $H_t^\dagger$,有
$$ H_t^\dagger G_t=\operatorname{polar}(G_t), \qquad H_tH_t^\dagger G_t=G_t. $$因此理想 Muon 可以写成 $W_{t+1}=W_t-\eta_tH_t^\dagger G_t$。这个表达式也覆盖非方阵和秩亏矩阵;满行秩时,伪逆就是普通逆。
它在 Adafactor 一节的变度量分析中对应的梯度能量是
$$ \operatorname{tr}(G_t^\top H_t^\dagger G_t) =\operatorname{tr}(\Sigma_t) =\sum_j\sigma_j(G_t) =\|G_t\|_*. $$这里 $\|\cdot\|_*$ 专指核范数,即奇异值之和。SGD 的能量是 $\mathbb E\|g_t\|^2$;理想 Muon 在这个证明里出现的则是 $\mathbb E\|G_t\|_*$。
建立终点上界
继续使用 $S=\sum_t w_t$ 和 $\eta_t=w_t\sum_{s>t}w_s/S$。辅助矩阵按
$$ Z_{t+1}=Z_t-w_tH_t^\dagger G_t, \qquad Z_1=W_1 $$更新。令 $E_t=Z_t-W_*$,使用半范数 $\|E\|_H^2=\operatorname{tr}(E^\top HE)$。由 $H_tH_t^\dagger G_t=G_t$,直接展开得到
$$ 2w_t\langle G_t,E_t\rangle_F =\|E_t\|_{H_t}^2-\|E_{t+1}\|_{H_t}^2 +w_t^2\|G_t\|_*. $$$H_t$ 依赖当前梯度,并不妨碍这个逐样本恒等式成立。但它不具有累计 AdaGrad 的单调性,因此需要保留矩阵变差
$$ \Lambda_T^{\rm Muon} =\lambda_{\max}(H_1) +\sum_{t=2}^{T}[\lambda_{\max}(H_t-H_{t-1})]_+. $$假设目标凸、$G_t$ 在当前 $W_t$ 处条件无偏,辅助轨迹满足 $\|E_t\|_F\leq R$。代入终点转换,就得到
$$ \boxed{ \mathbb E[f(W_T)-f_*] \leq \frac{R^2\mathbb E\Lambda_T^{\rm Muon} +\sum_t w_t^2\mathbb E\|G_t\|_*}{2S}. } $$这里没有额外乘上矩阵列数,因为变化项直接满足
$$ \operatorname{tr}(E_t^\top\Delta H_t E_t) \leq R^2[\lambda_{\max}(\Delta H_t)]_+. $$求出依赖梯度谱的 LR Schedule
对候选 LR Schedule 采用共同的确定性界
$$ R^2\mathbb E\Lambda_T^{\rm Muon}\leq A,\qquad \mathbb E\|G_t\|_*\leq a_t, \qquad A>0,\ a_t>0. $$要最小化的表达式为
$$ \mathcal B_{\rm Muon}(w) =\frac{A+\sum_t a_tw_t^2}{2\sum_t w_t}. $$令 $Q_t=\sum_{s=1}^{t}a_s^{-1}$。沿用 SGD 中的权重优化,固定总和时 $w_t\propto a_t^{-1}$,再对总和求极小,得到
$$ \boxed{ \eta_t^{\rm Muon} =\sqrt{\frac{A}{Q_T}}\frac1{a_t} \left(1-\frac{Q_t}{Q_T}\right),\qquad \mathcal B_{\min}=\sqrt{\frac{A}{Q_T}}. } $$若核范数能量用同一个常数 $a$ 控制,便有
$$ \boxed{ \eta_t^{\rm Muon} =\sqrt{\frac{A}{aT}}\left(1-\frac tT\right). } $$这是常数能量界下的一个特例。这里优化的是 $\mathcal B_{\rm Muon}$,没有直接求出某个具体训练任务的真实终点损失最小值。解出的权重还须处于共同距离界、能量界成立的候选集合中。非恒定轮廓下,调度随核范数能量及其剩余累积量变化。若 $a_t$ 来自一次预训练记录,这仍然是依赖旧轨迹和未来统计的 refinement,不能直接当作可在线实现的最优控制。
要让这个上界随训练步数趋于零,还需要 $A/Q_T\to0$。$A$ 包含预条件矩阵的累计变化:即使核范数能量稳定,$H_t$ 的方向振荡也可能使 $\Lambda_T^{\rm Muon}$ 随 $T$ 线性增长。
动量 Muon 中必须保留的修正
本小节将第 $t$ 步送入正交化的矩阵记为 $M_t$,它可以是普通动量,也可以包含 Nesterov 修正。用 $H_t=(M_tM_t^\top)^{1/2}$ 重复上面的代数,控制的是 $\langle M_t,Z_t-W_*\rangle_F$;凸性需要的仍然是当前随机梯度 $G_t$。两者相差
$$ \mathcal C_T =\frac1S\sum_t w_t\, \mathbb E\langle G_t-M_t,Z_t-W_*\rangle_F. $$因此,在精确极分解、无权重衰减的动量版本中,上界变为
$$ \mathbb E[f(W_T)-f_*] \leq \frac{R^2\mathbb E\Lambda_T(M) +\sum_t w_t^2\mathbb E\|M_t\|_*}{2S} +\mathcal C_T. $$即使动量的核范数近乎恒定,$\mathcal C_T$ 也不自动为零。可以用辅助轨迹的距离界,将它控制为
$$ \mathcal C_T\leq\frac1S\sum_t w_tb_t, \qquad b_t\geq R\,\mathbb E\|G_t-M_t\|_F. $$取 $a_t\geq\mathbb E\|M_t\|_*$、$A\geq R^2\mathbb E\Lambda_T(M)$,并将它们与 $b_t$ 一起固定为候选调度的共同界,就得到 Adam 一节的 $\mathcal B_{\rm mom}(w)$。因此在正分支成立时,仍由
$$ \sum_t\frac{(\lambda-b_t)^2}{a_t}=A,\qquad w_t^*=\frac{\lambda-b_t}{a_t},\qquad \eta_t^*=w_t^*\frac{\sum_{s>t}w_s^*}{\sum_sw_s^*} $$确定上界最优调度。这里的能量换成了动量矩阵的核范数;动量的核范数稳定,并不意味着偏差项 $b_t$ 可以省略。
上述结果要求 $A,a_t,b_t$ 对候选 LR Schedule 共同成立。
矩阵级倍率也会进入结果。若理想更新是 $s_t\operatorname{polar}(G_t)$,其中 $s_t>0$,可将度量改为 $H_t/s_t$:能量变成 $s_t\|G_t\|_*$,矩阵变差也须同时改变。对恒定 $s>0$,学习率相应除以 $s$,实际位移保持一致。多个矩阵共用一个 LR Schedule 时,可以在分块度量下累加能量和变差;包含 AdamW 参数组的混合优化器,还需纳入那些参数组自身的界。
把有限次 Newton–Schulz 纳入上界
仍暂不加权重衰减。直接使用实际更新 $U_t=s_t\Phi(M_t)$,取 $H_t=(M_tM_t^\top)^{1/2}/s_t$,定义能量与残差
$$ e_t=\operatorname{tr}(U_t^\top H_tU_t),\qquad \Delta_t=G_t-H_tU_t. $$辅助更新改为 $Z_{t+1}=Z_t-w_tU_t$。对 $E_t=Z_t-W_*$,距离展开是逐步成立的恒等式:
$$ 2w_t\langle G_t,E_t\rangle_F=\|E_t\|_{H_t}^2-\|E_{t+1}\|_{H_t}^2+w_t^2e_t+2w_t\langle\Delta_t,E_t\rangle_F. $$因此,共同界应取 $a_t\geq\mathbb E e_t$、$b_t\geq R\mathbb E\|\Delta_t\|_F$,再优化同一个 $\mathcal B_{\rm mom}$。精确极分解时恢复 $e_t=s_t\|M_t\|_*$、$\Delta_t=G_t-M_t$;有限次迭代时,能量与偏差界都要改变。
Warmup 与零终点约束
固定 warmup 后,真实训练从其结束时的参数与动量缓存继续,只把辅助序列重新设为该处的参数,不能清零真实动量。若后续候选调度共同满足常数界 $A,a,b$,则上界为 $\mathcal B_{\rm mom}=(A+a\sum_tw_t^2)/(2S)+b$:常数 $b$ 抬高上界,最佳权重仍相等,外部 LR 因而线性降到 $0$。若 $a_t$ 或 $b_t$ 随时间变化,这个结论就不再直接成立。
这里得到的是常数界下的最优衰减形状,峰值与 warmup 长度仍需另行确定;不能据此判定实际 Muon 训练的最佳曲线。
带动量时,真实终点如何求解
带动量 Muon 要保留参数与动量缓存两个状态。以 Nesterov、固定 $\beta$、矩阵倍率 $s$ 和衰减系数 $\lambda_{\rm wd}$ 为例,以下从 $t=0$ 开始计数:
$$ B_{t+1}=\beta B_t+(1-\beta)G(W_t,\xi_t),\qquad M_t=(1-\beta)G(W_t,\xi_t)+\beta B_{t+1}. $$参数更新为 $W_{t+1}=(1-\lambda_{\rm wd}\eta_t)W_t-\eta_ts\Phi(M_t)$;普通动量则取 $M_t=B_{t+1}$。$\Phi$ 可以是精确极分解,也可以是实际的有限次 Newton–Schulz 变换。把每一步非负学习率都作为变量,要解的是
$$ \min_{\eta_0,\ldots,\eta_{N-1}\geq0} J(\eta)=\mathbb E_\xi f(W_N(\eta)). $$写 $X_t=(W_t,B_t)$,将完整更新记为 $X_{t+1}=F_t(X_t,\eta_t,\xi_t)$。这里 $\xi$ 的分布不依赖学习率;若噪声随参数变化,其依赖须已包含在 $G(W,\xi)$ 中。在可微且可交换求导与期望的条件下,对固定的样本序列反向传播:
$$ p_N=(\nabla f(W_N),0),\qquad p_t=(D_XF_t)^\top p_{t+1}. $$于是每一个时刻的学习率梯度为
$$ \boxed{ \frac{\partial J}{\partial\eta_t} =-\mathbb E\left\langle p_{t+1}^{W},\, s\Phi(M_t)+\lambda_{\rm wd}W_t \right\rangle_F. } $$对内部最优点,这个导数为零;若最优值落在 $\eta_t=0$,相应右导数应非负。$p_{t+1}^{W}$ 衡量当前位移对最终损失的影响,已经包含此后所有梯度、动量和正交化的变化。若只优化下一步真实损失 $f(W_{t+1})$,对应导数使用 $\nabla f(W_{t+1})$;使用当前梯度只给出一阶下降近似。
沿完整训练轨迹反向传播,可以计算 $\nabla_\eta J$,再在非负约束下优化各步学习率[11] 。这个外层问题一般非凸,驻点条件只是必要条件;具体解依赖目标、数据分布和训练预算,通常需要数值求解。精确极分解在秩变化处还可能不可微。
若问题额外固定 warmup 前缀,就只优化其后的学习率;若要求最后一次实际更新的学习率为零,也应固定该变量。若进一步把衰减段限定为直线,形状已经由约束指定,剩下要选的是峰值等尚未固定的参数。这与允许所有非负学习率序列参与比较,是不同的优化问题。
补充:一个特殊矩阵模型的精确解,为什么可以不是 Linear
这里改为直接最小化一个二次模型的真实终点损失,优化所有非负标量步长,不固定 warmup,也不要求最后一次实际更新的步长为零。模型使用等奇异值参数和与参数列空间正交的特殊噪声,并去掉动量。下面得到的反比渐近形状只属于这个模型,不是实际 Muon 的通用最优 LR Schedule。
模型与噪声假设
设 $W_t\in\mathbb R^{m\times k}$,$m\geq2k$,目标为
$$ f(W)=\frac h2\|W\|_F^2, \qquad h>0. $$初始矩阵满足 $W_0^\top W_0=(r_0/k)I_k$,$r_0>0$。也就是说,它的 $k$ 个奇异值相等。令 $r_t=\|W_t\|_F^2$,随机梯度取为
$$ G_t=hW_t+\Xi_t, $$其中噪声满足
$$ \mathbb E[\Xi_t\mid\mathcal F_{t-1}]=0,\qquad W_t^\top\Xi_t=0,\qquad \Xi_t^\top\Xi_t=\frac{\sigma^2}{k}I_k, \qquad \sigma>0. $$这里的噪声与当前参数列空间正交,且 Frobenius 范数固定为 $\sigma$。这样的无偏随机梯度确实可以构造:在 $W_t$ 的正交补中取 $k$ 个正交单位向量组成 $O_t$,再令 $\Xi_t=\pm\sigma O_t/\sqrt k$,正负号独立且等概率。条件 $m\geq2k$ 保证有足够的正交补空间。
噪声的方向依赖当前参数,因而不同于固定分布的加性高斯噪声,也不同于 SGD 一节的标量加性噪声模型。两节的数值用于各自模型内比较调度,不用于比较优化器的优劣。在这些条件下,损失可以由一个标量状态精确递推。
若当前 $W_t^\top W_t=(r_t/k)I_k$,则
$$ G_t^\top G_t =\frac{h^2r_t+\sigma^2}{k}I_k. $$因此精确极分解有显式表达式:
$$ U_t=\operatorname{polar}(G_t) =\frac{\sqrt k\,G_t}{\sqrt{h^2r_t+\sigma^2}}, \qquad U_t^\top U_t=I_k. $$将它代入 $W_{t+1}=W_t-\eta_tU_t$,得到
$$ \boxed{ r_{t+1} =r_t-\frac{2\eta_t h\sqrt k\,r_t} {\sqrt{h^2r_t+\sigma^2}}+k\eta_t^2. } $$这个等式对每个噪声样本都成立,尚未取期望。与此同时,
$$ W_{t+1}^\top W_{t+1}=\frac{r_{t+1}}kI_k, $$所以初始的等奇异值结构保持不变。因此,损失的演化只需跟踪标量 $r_t$。
配方,再证明全程最优
把上面的递推配方:
$$ r_{t+1} =\frac{\sigma^2r_t}{h^2r_t+\sigma^2} +k\left( \eta_t-\frac{hr_t}{\sqrt k\sqrt{h^2r_t+\sigma^2}} \right)^2. $$因此,当前状态下的最优步长是
$$ \eta^*(r)=\frac{hr}{\sqrt k\sqrt{h^2r+\sigma^2}}, $$其最小下一步状态为
$$ \phi(r)=\frac{\sigma^2r}{h^2r+\sigma^2}. $$还差一步才能称为全程最优。注意
$$ \phi'(r)=\frac{\sigma^4}{(h^2r+\sigma^2)^2}>0. $$任意非负学习率都有 $r_{t+1}\geq\phi(r_t)$。由于 $\phi$ 单调,归纳可得
$$ r_N\geq\phi^{\circ N}(r_0). $$每一步选择 $\eta^*(r_t)$ 会达到等号。因此它同时最小化任意预算 $N$ 下的 $f(W_N)=hr_N/2$。这不仅覆盖预先设定的 LR Schedule,也覆盖根据历史、甚至当前噪声选择标量步长的策略:配方得到的下界对每条轨迹都成立。
解出时间形式
最优状态满足
$$ \frac1{r_{t+1}^*}=\frac1{r_t^*}+\frac{h^2}{\sigma^2}. $$记 $c=\sigma^2/(h^2r_0)$,于是
$$ r_t^*=\frac{\sigma^2}{h^2(t+c)}. $$代回步长,得到这个特殊模型中、无预设 warmup 与末次零步长约束的精确最优解:
$$ \boxed{ \eta_t^* =\frac{\sigma}{h\sqrt k} \frac1{\sqrt{(t+c)(t+c+1)}},\qquad \mathbb E f(W_N)_{\min} =\frac{\sigma^2}{2h(N+c)}. } $$它没有在预定终点归零,且当 $t\gg c$ 时,
$$ \eta_t^*\sim\frac{\sigma}{h\sqrt k}\frac1t. $$矩阵宽度 $k$ 的因子来自 $\|U_t\|_F^2=k$。若实现使用 $sU_t$、$s>0$ 为固定倍率,则对应学习率为 $\eta_t^*/s$。
由于梯度的奇异值相等,极分解在这里等价于整体归一化。若改用同一个随机梯度做 SGD,相同位移对应
$$ \eta_t^{\rm SGD} =\frac{\sqrt k}{\sqrt{h^2r_t+\sigma^2}}\eta_t^{\rm Muon}. $$在最优轨迹上,它化为 $\eta_t^{\rm SGD}=1/[h(t+c+1)]$。两种优化器能走出同一条参数轨迹,但对应的外部学习率并不相同。一般矩阵的奇异值不相等时,极分解会分别改变各个谱方向,这个标量换算就不再成立。
取 $h=\sigma^2=r_0=1$、$k=4$,总预算 $N=100$ 次更新。与 SGD 图相同,前 $W=5$ 次更新固定为共同 warmup:$\eta_t=a\,t/W$。共同峰值通过 $a=r_W/[2\sqrt{1+r_W}]$ 选择,使最优尾段与 warmup 连续衔接;数值为 $a\approx0.1670512787$、$r_W\approx0.3945444947$。
令 $j=t-W$、$c_W=1/r_W$,固定 warmup 后的精确最优尾段为 $\eta_t^*=1/[2\sqrt{(j+c_W)(j+c_W+1)}]$。Linear、Cosine 和 Constant 分别使用 $a(1-j/95)$、$a[1+\cos(\pi j/95)]/2$ 和 $a$。四组共用峰值,损失从训练起点重新递推;这里没有分别搜索幅值,也没有优化 warmup 本身。

| LR Schedule | 共同峰值 | 第 100 步期望损失 |
|---|---|---|
| 固定 warmup 后的最优解 | $0.1670513$ | $0.0051264$ |
| Linear | $0.1670513$ | $0.0132669$ |
| Cosine | $0.1670513$ | $0.0128032$ |
| Constant | $0.1670513$ | $0.0907930$ |
这个精确解依赖等奇异值与正交噪声假设。各向异性梯度、动量或近似正交化都会改变递推,$1/t$ 的渐近形状也不再由上述证明保证。
在这个特殊模型中,固定 warmup 前缀只会改变后续推导的初始状态 $r_\tau$,不会改变配方和单调性证明。若 $\eta_N=0$ 只是预算结束后不再执行的边界值,它不影响终点损失;若要求最后一次实际更新 $\eta_{N-1}=0$,则其前仍按上述公式优化,末步保持参数不变。固定 warmup 和终点归零本身,并不能推出中间必须是一条直线。
补充:一步下降上界,以及 Hyperball 的步长换算
对于一般方向 $u_t$,可以先解一个较局部的问题。假设 $f$ 的梯度是 $L_s$-Lipschitz,条件在更新前的历史上,定义
$$ \mathcal A_t=\mathbb E[\langle\nabla f(\theta_t),u_t\rangle\mid\mathcal F_{t-1}],\qquad \mathcal V_t=\mathbb E[\|u_t\|^2\mid\mathcal F_{t-1}]. $$光滑性给出
$$ \mathbb E[f(\theta_t-\eta u_t)\mid\mathcal F_{t-1}] \leq f(\theta_t)-\eta \mathcal A_t+\frac{L_s\eta^2\mathcal V_t}{2}. $$当 $\mathcal V_t>0$,这个二次上界在非负步长中的最小值取于
$$ \boxed{\eta_t^{\rm one}=\frac{[\mathcal A_t]_+}{L_s\mathcal V_t}.} $$分子度量方向与真实梯度的对齐,分母度量更新的平方长度。它允许不同优化器使用不同的 $u_t$,但解的是当前这一步的上界,不是固定终点的全程最优控制。
对无偏 SGD,若梯度噪声协方差为 $\Sigma_t$,上式化为
$$ \eta_t^{\rm one} =\frac{\|\nabla f(\theta_t)\|^2} {L_s\bigl(\|\nabla f(\theta_t)\|^2+\operatorname{tr}\Sigma_t\bigr)}. $$当信号相对噪声变小,一步最优上界步长下降。若更新带动量或者根据当前梯度生成预条件子,就必须重新计算 $\mathcal A_t,\mathcal V_t$,不能默认它们仍有这个表达式。
正交化改变了长度与对齐
Muon 对动量矩阵做近似正交化,实际实现还涉及 Newton–Schulz 近似与矩阵形状相关的倍率[8] 。先去掉这些实现因素,考虑无噪声、无动量的理想情形:令真实矩阵梯度的紧致 SVD 为
$$ G=P\Sigma Q^\top,\qquad U=PQ^\top, \qquad r=\operatorname{rank}(G)>0. $$直接计算得到
$$ \langle G,U\rangle_F=\sum_j\sigma_j(G)=\|G\|_*, \qquad \|U\|_F^2=r. $$所以这一理想方向的一步上界最优步长为
$$ \boxed{\eta^{\rm one}=\frac{\|G\|_*}{L_sr}.} $$如果实现还乘了一个标量 $s>0$,即使用 $sU$,对应学习率会变成 $\|G\|_*/(L_ssr)$。更新的倍率必须与学习率约定一起讨论。
真实 Muon 对动量矩阵而非当前真实梯度做变换,随机正交化又是非线性的,此时对齐项一般不是 $\|\nabla f\|_*$。即使输出矩阵的 Frobenius 范数近乎固定,也没有固定它与真实梯度的夹角,因此不能只由“更新长度稳定”确定全程最优 LR Schedule。
Hyperball 调度的是投影前的相对步长
Hyperball 的受约束参数块使用
$$ W^+=R\frac{W-\eta_H R\,U/\|U\|_F} {\|W-\eta_H R\,U/\|U\|_F\|_F}, \qquad \|W\|_F=R. $$这个归一化包装器可以接在 Adam 或 Muon 后面[9] 。这里假设 $R>0$、$U\ne0$;零更新可直接跳过。记 $c=\langle W/R,U/\|U\|_F\rangle_F$。当 $0\leq\eta_H<1$,实际转角满足
$$ \theta=\arctan\frac{\eta_H\sqrt{1-c^2}}{1-\eta_Hc}. $$推导见 Hyperball 的几何分析 。只有在小步长且更新近乎切向时,才有 $\theta\approx\eta_H$。对一般 $c$,给 $\eta_H$ 一条直线并不会给出严格线性的转角。
若目标是匹配普通更新 $W^+=W-\eta_{\rm direct}U$ 的投影前位移,则必须换算
$$ \eta_{\rm direct} =\frac{\eta_H R}{\|U\|_F}. $$后续求最优 LR Schedule 时,还需要把球面投影写进损失递推。前面的欧氏终点定理和一步光滑性上界,都不能原样套在投影后的完整更新上。
五、MuonH:反平方根解与线性收尾
MuonH 将带动量的 Muon 更新包在固定范数投影中。因而,普通 Muon 的欧氏收敛界不能直接决定 MuonH 的最优 ELR。下面从球面递推求解:先给出一个可精确求解的方向统计模型,再加入末步归零的约束。
带动量 MuonH 的精确更新
考虑一个半径固定为 $R\gt 0$、不另加解耦权重衰减的矩阵块,记 $w_j=W_j/R$、$\|w_j\|_F=1$。以 Nesterov 动量和五步 Newton–Schulz 为例,方向的计算是
$$ B_{j+1}=\beta B_j+(1-\beta)G_j,\qquad M_j=(1-\beta)G_j+\beta B_{j+1},\qquad D_j=\frac{\Phi_5(M_j)}{\|\Phi_5(M_j)\|_F}. $$$0\leq\beta\lt 1$,$G_j$ 是随机梯度,$\Phi_5$ 包含输入归一化和五步矩阵迭代;普通动量版本将 $M_j$ 换成 $B_{j+1}$。假设方向非零,MuonH 的更新可精确写成[9][14]
$$ \boxed{w_{j+1}=\frac{w_j-\varepsilon_jD_j}{q_j},\qquad q_j=\sqrt{1-2\varepsilon_jc_j+\varepsilon_j^2},\qquad c_j=\langle w_j,D_j\rangle_F.} $$这里 $\varepsilon_j$ 是投影前位移除以参数范数,即本文使用的 ELR;MuonH 已归一化更新长度,所以它也就是该矩阵块的学习率。$q_j\gt 0$ 时公式成立。动量没有被去掉,它通过 $B_j$ 影响 $D_j$,而 $B_j$ 累积历史梯度,梯度又随之前的参数更新变化。
选一个固定单位目标方向 $V$,令 $z_j=\langle w_j,V\rangle_F$。真正需要分析的是
$$ z_{j+1}=\frac{z_j-\varepsilon_j\langle D_j,V\rangle_F}{\sqrt{1-2\varepsilon_jc_j+\varepsilon_j^2}}. $$归一化只固定 $\|D_j\|_F$,没有固定径向分量 $c_j$,也没有固定方向与 $V$ 的对齐。它们正是决定 schedule 的量。
切向对齐模型:反平方根是全程最优解
沿用 AIR 的对齐建模思路[18] ,先固定 warmup 及其结束时的状态分布,只优化之后 $N$ 步的确定性 ELR 序列。以下结论需要三个条件:
- 每条轨迹上,更新方向都在当前球面的切空间中,即 $c_j=0$。
- 对齐漂移 $a_j=-\mathbb E\langle D_j,V\rangle_F\gt 0$ 是预先给定的序列,且对所有候选 schedule 都相同。
- 优化目标是终点的期望对齐损失 $\mathbb E\ell_N$,其中 $\ell_j=1-\langle w_j,V\rangle_F$;warmup 后 $m_0=\mathbb E z_0\gt 0$。
第二个条件尤其强:改变 schedule 通常会改变动量与后续梯度,从而改变 $a_j$。单独测出某次训练的 $a_j$,再将它用于所有候选曲线,并不能验证这个条件。切向性也不由 Newton–Schulz 归一化自动保证。
在这些条件下,期望对齐 $m_j=\mathbb E z_j$ 满足精确递推
$$ m_{j+1}=F_j(m_j,\varepsilon_j):=\frac{m_j+a_j\varepsilon_j}{\sqrt{1+\varepsilon_j^2}}. $$因为 $\varepsilon_j$ 是确定性的、分母与随机方向无关,这一步不需要小步长展开。对任意非负 $\varepsilon$,有恒等式
$$ \boxed{m^2+a_j^2-F_j(m,\varepsilon)^2=\frac{(m\varepsilon-a_j)^2}{1+\varepsilon^2}\geq0.} $$因此任意候选序列都满足 $m_N^2\leq m_0^2+\sum_{j=0}^{N-1}a_j^2$。逐步取 $\varepsilon_j=a_j/m_j$,每一步都能取到等号,故同时达到了终点对齐的全局上界:
$$ \boxed{\varepsilon_j^*=\frac{a_j}{\sqrt{m_0^2+\sum_{s\lt j}a_s^2}},\qquad m_j^{*2}=m_0^2+\sum_{s\lt j}a_s^2.} $$这证明的是整个有限区间上的最优序列,而不仅是某一步的驻点。由于 $\mathbb E\ell_N=1-m_N$,它也最小化了这里指定的期望损失。换成一般交叉熵后,这个等价关系需要重新证明。
若对齐漂移恒定为 $a\gt 0$,记 $E=a/m_0$,解就变成
$$ \boxed{\varepsilon_j^*=\frac{E}{\sqrt{1+E^2j}}.} $$所以,恒定对齐漂移模型给出的形状是反平方根衰减。在本文 ELR 定义下,更新长度已经吸收到 $\varepsilon$ 中,分母的系数不是一个可以另行调节的噪声参数。理论区间还必须满足几何可实现性;例如 $m_0^2+Na^2\leq1$ 是最优标量轨迹不越过单位对齐的必要检查,不能替代对方向统计假设的验证。
要求末步为零:什么时候出现线性收尾?
反平方根解在有限的 $j$ 上始终为正。若仅在最后一次更新之后记录一个未使用的零学习率,优化问题没有改变;若要求最后一次实际更新取零,则是在可行集中加入了一个约束。这个约束本身不会自动产生 AIR,也不会自动产生一段平滑的线性衰减。
下面进一步求解这个标量模型的约束问题:warmup 接到峰值 $E=a/m_0$,余下 $N\geq2$ 次实际更新单调衰减,末步为零,每步最多下降 $\delta$。即
$$ \varepsilon_0=E,\qquad \varepsilon_{N-1}=0,\qquad 0\leq\varepsilon_j-\varepsilon_{j+1}\leq\delta\quad(0\leq j\lt N-1). $$这里 $\delta$ 是额外指定的调度约束,不能由 MuonH 的定义推出。在恒定 $a$ 的对齐模型下,如果
$$ \delta(N-1)\geq E,\qquad \delta\geq E-\frac{E}{\sqrt{1+E^2}}, $$则上述约束问题有显式全局最优解
$$ \boxed{\varepsilon_j^*=\min\!\left\{\frac{E}{\sqrt{1+E^2j}},\ \delta(N-1-j)\right\}.} $$它先沿反平方根衰减,再接到斜率为 $-\delta$ 的直线,以零结束。某些参数下,一段可能退化。
证明。 由末步为零和最大下降幅度可知,任意可行序列都必须满足 $\varepsilon_j\leq u_j:=\delta(N-1-j)$。先只保留这些逐步上限,暂时放宽相邻步之间的约束。
对这个放宽后的问题,有
$$ \frac{\partial F(m,\varepsilon)}{\partial\varepsilon}=\frac{a-m\varepsilon}{(1+\varepsilon^2)^{3/2}},\qquad \frac{\partial F(m,\varepsilon)}{\partial m}=\frac1{\sqrt{1+\varepsilon^2}}\gt 0. $$故当前最大可达对齐对应 $\varepsilon=\min\{a/m,u_j\}$。由于后续递推对输入状态单调递增,较大的当前对齐不会损害任何后续选择;逐步最大化便得到全程最大终点对齐。
记无约束解为 $h_j=E/\sqrt{1+E^2j}$。它的逐步下降量满足 $h_j-h_{j+1}\leq h_0-h_1\leq\delta$,所以 $u_j-h_j$ 单调不增,两条曲线至多切换一次。在上限尚未激活时,最优序列就是 $h_j$。上限激活后,由前面的平方恒等式,任何轨迹都有 $m_j\leq\sqrt{m_0^2+ja^2}$,从而
$$ u_j\leq h_j=\frac{a}{\sqrt{m_0^2+ja^2}}\leq\frac{a}{m_j}. $$因此之后一直由上限决定,即 $\varepsilon_j=u_j$。得到的序列为 $\min\{h_j,u_j\}$。
最后检查被放宽的条件。反平方根段的单步下降不超过 $\delta$,直线段的下降等于 $\delta$;若在 $j$ 切换,则 $u_{j-1}\geq h_{j-1}$ 且 $u_j\leq h_j\lt h_{j-1}$,于是 $0\leq h_{j-1}-u_j\leq\delta$。首尾也满足要求。这条放宽问题的最优解本身属于原可行集,所以就是原问题的全局最优解。
这个证明没有覆盖任意峰值或更小的 $\delta$。若 warmup 的峰值不是 $a/m_0$,或规定的下降幅度不满足条件,就需要求解相应的新约束问题。

图中共 3200 步,前 160 步使用相同的线性 warmup。之后取 $m_0=0.25$、$a=0.0075$、$E=0.03$、$\delta=6\times10^{-5}$;四条曲线的末次实际更新都为零,且都满足同一个最大下降幅度约束。AIR 使用 $\alpha=(N-1)/8$。右图画的是精确递推的模型损失 $1-m_j$,不是 LLM 训练损失。warmup 固定,不参与最优性比较。
这是否已经证明了实际 MuonH 的最优曲线?
以上证明确定了两个条件性答案:无端点限制时为反平方根;加入指定的单调性、零终点和下降幅度约束后,为反平方根接线性。第二个结果来自上面求解的约束问题,不能据此宣称 PuRo 的完整配方或 AIR 的仿射变换也已被证明最优。
实际 MuonH 还需要处理 $c_j\ne0$、随训练变化的对齐漂移,以及动量对整条轨迹的依赖。仅靠“使用了 MuonH”无法固定这些量。一个保留动量和有限步 Newton–Schulz 的例子就能说明这一点。
令损失为 $L(W)=-\langle A,W\rangle_F$,其中 $A$ 是单位 Frobenius 范数的秩一矩阵,初始对齐 $r_0=\langle w_0,A\rangle_F\in[0,1)$。梯度恒为 $-A$,零初始动量在普通或 Nesterov 更新中都保持在同一条射线上;五步 Newton–Schulz 也保持该方向6,故归一化后始终有 $D_j=-A$。此时精确递推是
$$ r_{j+1}=\frac{r_j+\varepsilon_j}{\sqrt{1+2\varepsilon_jr_j+\varepsilon_j^2}},\qquad \frac{\partial r_{j+1}}{\partial\varepsilon_j}=\frac{1-r_j^2}{(1+2\varepsilon_jr_j+\varepsilon_j^2)^{3/2}}\gt 0. $$它对输入对齐也单调递增,因为 $\partial r_{j+1}/\partial r_j=(1+\varepsilon_jr_j)/(1+2\varepsilon_jr_j+\varepsilon_j^2)^{3/2}\gt 0$。于是每一步都应取允许的最大步长:只有峰值上限时,最优解是常数;若保留上一节的峰值、单调性、最大下降幅度和零终点约束,最优解就是 $\min\{E,\delta(N-1-j)\}$,也就是平台接线性。该例不满足切向假设,因此与反平方根定理并不冲突。
要把反平方根定理用于实际预训练,需要建立对应训练目标下的方向统计模型,尤其是 $c_j$ 与 $-\mathbb E\langle D_j,V\rangle_F$ 如何随动量、噪声和 schedule 改变。现有实验中 Linear 或 Cosine 被其他曲线超过,足以说明它们在那些比较中不是最佳;它并未替这些尚未验证的假设提供证明。
六、直接求解带端点和预算约束的 Schedule
AIR 的反平方根定理没有指定峰值、终点或累计 LR;实际配方通过仿射变换满足端点,匹配累计 LR 时允许校准峰值[18] 。这里保留同一个切向、固定漂移的对齐模型,把这些条件直接放进优化问题。
本节求解的是这个模型的终点损失 $1-m_N$。共同漂移、固定目标方向等假设仍然保留,结论不等同于真实 MuonH 的训练损失最优性。
把约束写进问题
固定 warmup 后,设初始期望对齐为 $m_0\gt0$,还有 $N\geq2$ 次实际更新。使用精确离散递推
$$ F(m,\eta)=\frac{m+a\eta}{\sqrt{1+\eta^2}},\qquad m_{j+1}=F(m_j,\eta_j),\qquad a\gt0. $$给定峰值 $E\gt0$、零终点和累计 ELR 预算 $B$,直接求
$$ \max_{\eta_0,\ldots,\eta_{N-1}}m_N,\qquad \eta_0=E,\quad \eta_{N-1}=0,\quad 0\leq\eta_j\leq E,\quad \sum_{j=0}^{N-1}\eta_j=B. $$可行预算满足 $E\leq B\leq(N-1)E$。这里 $B$ 是各步 ELR 的总和,训练步数 $N$ 另行固定;没有沿用上一节的最大下降幅度约束,因此允许相邻步长跳变。warmup 已经固定,它消耗的累计 ELR 对所有候选相同。
固定峰值、终点和时长后,AIR 的形状参数会决定累计 ELR。因此与 AIR 比较时,也必须让它满足同一个 $B$,不能一边声称峰值固定,一边又缩放峰值来匹配预算。
单调衰减可以证明
先比较相邻的两个步长 $u,v\geq0$。记 $r(u)=(1+u^2)^{-1/2}$、$g(u)=u/(\sqrt{1+u^2}+1)$,直接展开得到
$$ F(F(m,u),v)-F(F(m,v),u)=a\,r(u)r(v)\,uv\,[g(u)-g(v)]. $$$g$ 单调递增,所以当 $u\geq v$ 时,先执行较大的步长不会降低这两步结束后的对齐。后续每一步又都满足 $\partial F/\partial m\gt0$,因此这个优势会保留到终点。
交换相邻步骤不改变预算或峰值上限。反复交换,就说明至少存在一条单调不增的全局最优序列。这是该模型的结论,无需预先指定 Linear、Cosine 或反平方根形状。零步长与其他步骤交换时可能取等号,所以不必声称最优序列唯一。
在步长网格上求全局解
先执行固定的首步峰值,得到 $s=F(m_0,E)$。中间有 $n=N-2$ 个自由步骤,剩余预算为 $C=B-E$;最后的零步不改变状态。
取整数 $K\geq1$,令 $h=E/K$,允许的步长为 $0,h,\ldots,Kh$,并要求 $Q=C/h$ 是整数。定义 $M_t(q)$ 为执行 $t$ 个自由步骤、累计使用 $qh$ 预算后,最大的可达对齐。初值为 $M_0(0)=s$,其他预算状态不可达。
动态规划递推为
$$ \boxed{M_{t+1}(q)=\max_{\substack{0\leq k\leq K\\q-k\text{ 可达}}}F\!\left(M_t(q-k),kh\right),\qquad V_h=M_n(Q).} $$为什么只保留一个对齐值就够了? 对相同的步数和已用预算,未来的可选序列相同。由于 $F$ 对输入对齐严格递增,较小的当前对齐不可能在相同后续选择下反超较大的状态。因此丢掉这些状态不会丢掉最优解。
这给出了整个网格可行集上的全局最优值,而不是从某个初值出发的局部最优候选。回溯得到的序列可以降序排列;交换定理保证这样做不会降低终点对齐。首尾再接上固定峰值与零步即可。
网格解离连续最优还有多远?
步长离散化需要有误差界。记连续可行域的最优对齐为 $V$。当 $E\leq1/\sqrt2$ 时,定义
$$ M=\sqrt{s^2+na^2},\qquad L_\eta=\max\{a,ME-a\},\qquad H_d=M+3aE,\qquad H_o=E L_\eta. $$则有
$$ \boxed{0\leq V-V_h\leq\mathcal E_h:=\frac{h^2}{8}\left(nH_d+n^2H_o\right).} $$对于模型损失 $1-m_N$,同样有 $0\leq L_h-L_{\mathrm{cont}}\leq\mathcal E_h$。这意味着网格步长减半,解析误差界缩小为原来的四分之一。这里的界与“多次搜索得到相近结果”不同,它控制的是未知的连续全局最优值。
连续域误差界的证明
连续可行域紧且目标连续,所以存在最优序列 $\eta^*$。将各坐标除以 $h$,先向下取整,再把剩余整数预算分配给小数部分最大的坐标。因为 $C/h$ 和 $E/h$ 都是整数,这种舍入保留总预算与上下界,且不改变原来位于 $0$ 或 $E$ 的坐标。记舍入误差为 $\delta$,则
$$ \sum_i\delta_i=0,\qquad \|\delta\|_1\leq nh/2,\qquad \|\delta\|_2^2\leq nh^2/4. $$后一个界可这样得到:对小数部分 $f_i$,存在保持整数总和、且每个坐标向上取整概率为 $f_i$ 的随机舍入,其期望平方误差是 $\sum_i f_i(1-f_i)\leq n/4$。选择最大小数部分向上取整,在所有保持总和的舍入中最小化平方误差,因此不大于这个期望。相同选择也最小化绝对误差,而 $\mathbb E\|\delta_{\mathrm{random}}\|_1=2h\sum_i f_i(1-f_i)\leq nh/2$,得到前一个界。
所有被改动的坐标都严格位于 $(0,E)$。在连续最优点,任意两个这样的坐标之间都允许小幅、双向、保持预算的扰动,因此它们的目标偏导必须相等。于是
$$ \nabla m_N(\eta^*)^\top\delta=0. $$这只使用未知全局最优点必须满足的必要条件,没有用驻点条件来宣称某个数值候选全局最优。
在自由区间内,令 $m_i$ 为第 $i$ 步之前的状态、$P_{\gt i}=\prod_{k\gt i}(1+\eta_k^2)^{-1/2}$、$J_i=\partial m_N/\partial\eta_i$。对任意候选序列,平方恒等式给出 $m_i\leq M$,而终点 Hessian 满足
$$ H_{ii}=P_{\gt i}\frac{m_i(2\eta_i^2-1)-3a\eta_i}{(1+\eta_i^2)^{5/2}},\qquad H_{ij}=-\frac{\eta_j}{1+\eta_j^2}J_i\quad(i\lt j). $$因此在 $E\leq1/\sqrt2$ 时,有 $|J_i|\leq L_\eta$、$|H_{ii}|\leq H_d$、$|H_{ij}|\leq H_o$。舍入线段始终位于连续可行域内,对它使用 Taylor 积分余项,得到
$$ V-V_h\leq\frac12\left(H_d\|\delta\|_2^2+H_o\|\delta\|_1^2\right)\leq\frac{h^2}{8}(nH_d+n^2H_o). $$由于交换定理保证连续域和网格域都存在单调最优解,这个界也适用于额外要求单调衰减的可行集。
与同预算 AIR 比较
取 160 次更新,其中前 8 步使用相同的线性 warmup。之后的 152 步取 $m_0=0.25$、$a=0.05$、峰值 $E=0.2$、末次实际更新为零,尾段累计 ELR 固定为 $B=7.65625$。加上 warmup 后,总累计 ELR 为 $8.45625$。
这个预算来自 $K=64$ 网格上的 AIR 量化值,因而在 $K=64,128,256$ 的嵌套网格上都能严格满足。图中的 AIR 对照在实际更新步上取值,不作步长量化,并通过形状参数 $\alpha=18.91714354$ 匹配同一个预算;它接近原始 $\alpha=(N-1)/8=18.875$,但没有把两者当成完全相同的配置。两条曲线的 warmup、峰值、终点、步数和累计 ELR 都相同。本例采用零终点,是对 AIR 函数族的比较,不是原论文训练实验的复现。
AIR 对照的尾段为
$$ \eta_j^{\mathrm{AIR}}=E\frac{(\alpha+j)^{-1/2}-(\alpha+N-1)^{-1/2}}{\alpha^{-1/2}-(\alpha+N-1)^{-1/2}},\qquad j=0,\ldots,N-1. $$
| Schedule | 模型终点损失 $1-m_N$ | 解析离散化误差界 $\mathcal E_h$ |
|---|---|---|
| 未量化 AIR,匹配预算 | 0.48695292 | — |
| $K=64$ 网格 DP 解 | 0.44680053 | 0.00058105 |
| $K=128$ 网格 DP 解 | 0.44678255 | 0.00014527 |
| $K=256$ 网格 DP 解 | 0.44677807 | 0.00003632 |
图中的 DP 序列在峰值后迅速降低,随后缓慢衰减,最后一跳落到零。末步跳变是当前约束允许的;若再限制相邻步长差值,就需要重新求解。
所求的 $K=256$ 序列在这个模型中比同预算 AIR 降低约 $0.04017$ 的终点损失。作为量化对照,最初在 $K=64$ 网格上量化的 AIR 损失为 $0.48698604$,与未量化 AIR 很接近,因此这个差异不是把 AIR 量化造成的。
该例满足 $m_0^2+Na^2=0.4425\lt1$,最优标量轨迹没有越过单位对齐的几何范围。数值实现还用向外舍入传播网格最优值和所选序列的上下界。所选序列距精确网格最优的损失差不超过 $4.5\times10^{-14}$;合并解析离散化误差后,其连续最优性差距不超过 $3.632\times10^{-5}$,连续最优模型损失被夹在
$$ 0.4467417516\leq L_{\mathrm{cont}}\leq0.4467780670. $$这里补上的,是给定端点与累计预算后,在 AIR 标量模型内直接求解最优序列。图中的纵轴是模型损失,不是 LLM 训练结果。真实 MuonH 的方向漂移随 schedule 改变、径向分量以及对齐与交叉熵的关系,仍不能由这个动态规划自动解决。
七、把模型推导的曲线放进真实 MuonH 训练
上一节在固定漂移的对齐模型内求出了优于同预算 AIR 的序列。将它用于语言模型训练后,还能得到同样的排序吗?这里做了一个小规模对照:训练前固定曲线和比较规则,共完成 14 次训练,再用三个新的随机种子比较同一留出测试段上的交叉熵。
结果是两次改善、一次退步。DP 曲线的平均 test CE 比 AIR 低 $0.016866$ nats/字符,但差异的不确定性仍然很大,尚不足以确认稳定优于 AIR。
训练设置与比较对象
数据使用 Tiny Shakespeare[22] ,按原始字符位置连续划分为 90% 训练集、5% 验证集和 5% 测试集。词表只从训练段构建,模型学习预测下一个字符。
| 项目 | 配置 |
|---|---|
| 模型 | 3 层 causal pre-LN Transformer,624,640 个参数 |
| 隐藏维度与注意力 | 宽度 128,4 个 attention heads,QKV 融合为一个矩阵 |
| MLP 与输出 | GELU,扩展倍数 4;输出头与输入嵌入不共享权重 |
| 输入与 batch | context 128,batch size 8,无 dropout |
| 每次训练 | 600 次更新,614,400 个字符 token,含 30 步 warmup |
| 计算 | Apple M2 CPU,FP32 |
隐藏的 attention 和 MLP 矩阵使用带 Nesterov 动量的 MuonH:$\beta=0.95$,五步 Newton–Schulz,保存每个矩阵的初始 Frobenius 范数,归一化更新后投回这个固定半径的球面[9][14] 。没有额外的切向投影,也没有对这些矩阵施加 weight decay。梯度来自语言模型交叉熵的实际反向传播。
嵌入、位置参数、输出头和 LayerNorm 参数使用独立的 AdamW,$\beta_1=0.9$、$\beta_2=0.95$、$\epsilon=10^{-8}$、weight decay 为零。它的峰值 LR 固定为 $10^{-3}$,两组都使用相同的 warmup → Cosine → 0。两组之间改变的只有隐藏矩阵的 MuonH schedule。
初始化、数值实现与评估细节
Linear 和 Embedding 权重使用标准差 0.02 的正态初始化,attention output 与 MLP output 的标准差再除以 $\sqrt{2L}$,这里 $L=3$。所有受约束矩阵均非零初始化。融合的 QKV 作为一个矩阵计算动量、Newton–Schulz 和半径;没有分别归一化 Q、K、V。
Newton–Schulz 使用系数 $(3.4445,-4.775,2.0315)$,输入先除以 Frobenius 范数加 $10^{-7}$。这里采用 FP32,官方 Muon 参考实现采用 BF16。没有 gradient clipping。学习率为零时仍计算当前 batch 的梯度并更新动量与 Adam 状态,但不移动参数。
同一随机种子下,两条曲线共享完全相同的模型初始化和预生成 minibatch 索引。每 100 步评估一次完整验证段;测试集只在规定的最终 checkpoint 上评估。评估使用固定、连续的 context 窗口,各段除第一个字符外的每个目标字符只计分一次,不跨越数据切分边界,也不按验证曲线挑选中途 checkpoint。
所有 14 次训练均完成。初始化、数据顺序、源码和配置经过核对;记录到的最大半径相对误差约为 $1.03\times10^{-6}$,实际投影前 ELR 与指定 ELR 的最大绝对差约为 $1.07\times10^{-7}$。
曲线如何迁移到 600 步
下文的 DP 曲线指上一节 $K=256$ 网格求出的序列经过时间插值和峰值缩放后得到的训练候选。原来的 152 个尾段值先除以模型峰值 0.2,再线性重采样为 570 个值,前面接上共同的 30 步 warmup。这些选择均在观察训练结果前固定;没有根据验证或测试损失修改曲线形状。
AIR 对照使用上一节的端点归一化公式。令尾段长度 $N=570$,仅通过调整 $\alpha$ 匹配 DP 曲线的离散累计 ELR,得到 $\alpha=71.31736502$。将两条完整曲线的峰值归一为 1 时,都有
$$ \sum_{t=0}^{599}\varepsilon_t/E=157.87893371. $$因此在最终选择的峰值 $E=0.1$ 下,两条曲线的累计 ELR 都是 $15.78789337$。它们共享 warmup、峰值、末次实际零更新、更新次数和累计 ELR,区别是这些步长在训练过程中的分配。
上一节的 $3.632\times10^{-5}$ 误差证书约束的是原始标量优化问题。这里改变了时间长度、峰值和训练目标,不能继续用该证书把迁移后的曲线称为真实训练的最优解。
峰值由 AIR 的验证结果选择
先固定开发种子 2026,在共同峰值 $E\in\{0.01,0.03,0.1,0.3\}$ 上分别训练两条曲线,共 8 次。选择规则预先规定为:只看 AIR 在第 600 步的验证损失,取其中最小者对应的峰值,再把这个峰值用于两组独立复测。 DP 的开发结果不参与峰值选择,这一阶段也不计算 test loss。
以下是全部开发结果,CE 的单位均为 nats/字符。差值定义为 DP − AIR,负数表示 DP 更低。
| 峰值 ELR | AIR 验证 CE | DP 验证 CE | DP − AIR |
|---|---|---|---|
| 0.01 | 2.409118 | 2.402964 | −0.006154 |
| 0.03 | 2.332495 | 2.306886 | −0.025609 |
| 0.1 | 2.276778 | 2.231361 | −0.045417 |
| 0.3 | 2.354757 | 2.448077 | +0.093321 |
AIR 选择的峰值为 0.1,位于候选范围内部。在峰值 0.3 下,DP 的验证 CE 高出约 0.0933。即使累计 ELR 与峰值相同,曲线之间的排序也会随峰值改变。
四个候选峰值的比较图
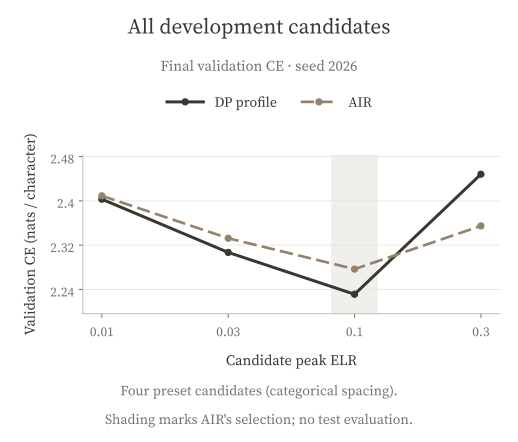
横轴将四个候选作为等距类别展示;阴影标记 AIR 选中的峰值。图中没有使用测试集指标。
三个新种子的测试结果
固定峰值 0.1 后,使用预先指定的种子 11、22、33 各训练一对模型,共 6 次。每对共享初始化和训练数据顺序;两种 schedule 都在第 600 步结束,随后评估同一份未参与调参的测试段。复测种子在开发阶段未使用,数据切分在所有训练中保持不变。
| 随机种子 | AIR 测试 CE | DP 测试 CE | DP − AIR |
|---|---|---|---|
| 11 | 2.288026 | 2.246672 | −0.041353 |
| 22 | 2.295548 | 2.312435 | +0.016886 |
| 33 | 2.277770 | 2.251640 | −0.026129 |
| 平均 | 2.287115 | 2.270249 | −0.016866 |
DP 在种子 11 和 33 上更好,在种子 22 上更差。平均 test CE 降低了 $0.016866$。
设配对差值为 $\Delta_s=L_s^{\mathrm{DP}}-L_s^{\mathrm{AIR}}$。三组结果的均值为 $\bar\Delta=-0.016866$,样本标准差为 $s_\Delta=0.030205$;按配对 $t$ 公式计算的描述性 95% 区间为
$$ \bar\Delta\pm t_{0.975,2}\frac{s_\Delta}{\sqrt3}=[-0.091898,\,+0.058167]. $$这个区间同时覆盖改善和退步。只有三个种子,区间本身也很不稳定;它只反映当前数据、架构和预算下的种子差异,不涵盖更换数据集或模型带来的不确定性。本次结果尚不足以确认稳定收益。

左图是实际使用的 MuonH ELR,右图是三组复测的平均 validation CE,阴影为正负一个样本标准差,不是置信区间。测试集只用于上表的终点比较。两条验证曲线的大部分区间接近,末段均值虽有分离,仍需结合逐种子的测试结果判断。
为什么模型中的最优性没有直接转移
首先,原问题优化的是 $1-m_N$,这里优化的是语言模型的交叉熵。没有证明“对某个固定方向的对齐更高”就意味着“验证或测试 CE 更低”。前节约 $0.04017$ 的改善与这里的 $0.016866$ 也不在同一个目标尺度上,不能用两者的比值衡量理论收益兑现了多少。
其次,真实 MuonH 的方向统计依赖训练轨迹。忽略浮点舍入,对单个参数块记 $w_t=W_t/R$,沿用第五节的单位 Muon 方向 $D_t$,并定义 $c_t=\langle w_t,D_t\rangle_F$。更新满足
$$ w_{t+1}=\frac{w_t-\varepsilon_t D_t}{\sqrt{1-2\varepsilon_t c_t+\varepsilon_t^2}}. $$即使指定一个固定单位参考方向 $V$,记 $z_t=\langle w_t,V\rangle_F$,其期望仍是
$$ \mathbb E[z_{t+1}]=\mathbb E\!\left[\frac{z_t-\varepsilon_t\langle D_t,V\rangle_F}{\sqrt{1-2\varepsilon_t c_t+\varepsilon_t^2}}\right]. $$固定权重范数并不使 $c_t$ 自动等于零。分母也可能与分子相关,不能把期望直接移入这个分式。改变 schedule 可能改变参数、梯度和动量缓存,进而影响 $D_t$、$c_t$ 以及参考方向上的漂移。它们没有跨 schedule 共同固定的保证,原来对所有候选共用同一个常数 $a$ 的递推不再自动成立。
动态规划中的状态压缩同样依赖这些条件。在原模型里,相同已用预算下更大的对齐值支配更小的对齐值;在真实网络里,仅知道一个对齐标量,并不能确定参数和动量状态,更不能保证未来交叉熵的排序。
本次训练记录了径向余弦和角向步长,但没有验证固定参考方向下的漂移能否在不同 schedule 间保持一致。这些是理论保证不能直接用于实训的原因;实验没有通过消融识别种子 22 退步的具体原因。
因此,这里检验的是一个冻结的模型推导曲线能否迁移到一次具体训练。它既不是 AIR 论文的大规模实验复现,也不构成对 AIR 条件性定理的反驳。一个数据集、一个约 62 万参数的模型、一个训练长度和三组随机种子,还不足以确定实际 MuonH 的最优 schedule。
-
该对齐模型要求 $m_0>0$、更新范数恒定,且 $a,b$ 对比较的候选 schedule 共同固定。若理论区间执行 $N$ 次更新,还需满足球面几何的可行条件 $m_0^2+Na^2/(2b)\leq1$。理论最优序列没有联合优化 warmup,也没有证明加上任意峰值、终点约束后的仿射 AIR 仍是同一问题的最优解。 ↩︎
-
正分支存在的条件是 $A>\sum_t(\max_s b_s-b_t)^2/a_t$。允许非负权重时,一般解为 $w_t=(\lambda-b_t)_+/a_t$,其中 $\sum_t(\lambda-b_t)_+^2/a_t=A$。零权重时,辅助参数和实际参数都不移动;只保留正权重的位置,就得到相同终点的正权重转换,不必假设梯度随权重连续。中间的动量或二阶矩仍可更新,这只改变保留位置上的辅助方向,而转换本身允许任意辅助更新。 ↩︎ ↩︎
-
终点转换包含 $T$ 个权重和梯度位置,但从 $\theta_1$ 到 $\theta_T$ 是 $T-1$ 次非零更新。末端 $g_T$ 用于理论界,不要求实现为了一个零步长再做反向传播。数值例子单独采用 $t=0,\ldots,N-1$,恰好执行 $N$ 次更新;Linear 在最后一次更新时为 $\alpha/N$,在预算边界 $t=N$ 才为零。 ↩︎ ↩︎
-
证明使用了单个状态 $r_t$ 和单调函数 $\phi$。多维二次损失用一个标量学习率时,不同特征方向的误差会耦合,一步最优一般不再自动意味着终点最优。这里也没有优化依赖当前样本或参数值的自适应反馈策略,只在确定性学习率序列中求最优。 ↩︎
-
对正标量单位阵输入,Newton–Schulz 的每个奇异值按 $\varphi(x)=x(3.4445-4.775x^2+2.0315x^4)$ 更新。括号作为 $x^2$ 的二次式,首项系数为正且判别式为 $-5.189382<0$,因此对 $x>0$ 输出仍为正。初始范数归一化同样保留正方向;配合 $\bar\varepsilon<1$,整个有限轨迹上的参数和更新范数都非零。 ↩︎
-
对秩一输入 $xA$,Newton–Schulz 仍在 $A$ 张成的射线上,沿 $A$ 方向的标量系数按 $x(3.4445-4.775x^2+2.0315x^4)$ 更新。括号对所有实数 $x$ 都为正,因此输入的正负方向保持不变。梯度恒定时,$0\leq\beta<1$ 的动量、Nesterov 组合及范数归一化也保持同一方向。 ↩︎
引用本文
@misc{jiang2026lrschedules,
  author = {Jiwen Jiang},
  title = {不同优化器的最优 LR 与 ELR Schedule},
  year = {2026},
  url = {https://jiwenj.github.io/blog/posts/lr-schedules/}
}